 우재남
3시간 전
SQLD 시험을 앞두고 SQL 문법을 다시 훑어보면 대부분 익숙하게 느껴집니다. 그러나 실행 순서, NULL 처리, 조인 결과처럼 문법은 알아도 결과를 정확히 예측하기 어려운 개념은 객관식 보기에서 쉽게 흔들립니다. SQLD 시험의 구성과 합격 기준을 먼저 정리하고, SQLD 유형 문제와 해설을 바탕으로 2과목 'SQL 기본 및 활용'에서 점검해야 할 핵심 개념 6가지를 살펴보겠습니다.
SQLD(SQL Developer, SQL 개발자)는 한국데이터산업진흥원이 시행하는 국가공인 자격으로, 관계형 데이터베이스의 데이터 모델링을 바탕으로 SQL을 작성·활용하는 능력을 시험합니다. 응시 자격에 제한이 없으며 대체로 연 4회 시행됩니다.
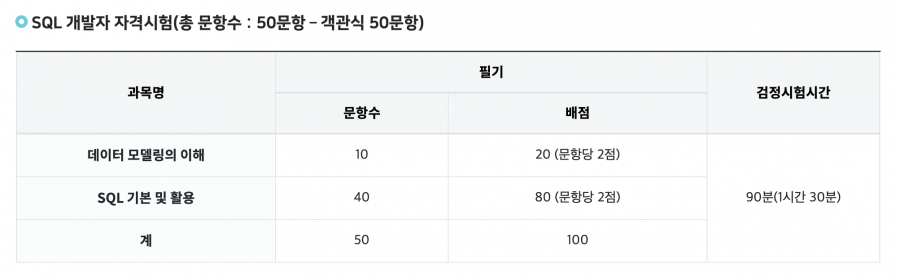
현행 기준 SQLD는 전 문항 객관식 50문항, 시험 시간 90분으로 시행됩니다. 문항당 2점으로 총 100점 만점이며, 두 과목으로 구성됩니다.
합격 기준은 총점 60점 이상이면서 과목별 40% 이상입니다. 따라서 1과목은 8점 미만, 2과목은 32점 미만이면 과락입니다. 총점이 60점 이상이어도 한 과목이라도 과락 기준에 걸리면 불합격이므로 두 과목을 균형 있게 준비해야 합니다. 시험 구성과 합격 기준은 개편될 수 있으므로, 시험 일정과 세부 기준은 데이터자격검정 사이트(https://www.dataq.or.kr/)의 공식 공고에서 확인해 주세요.
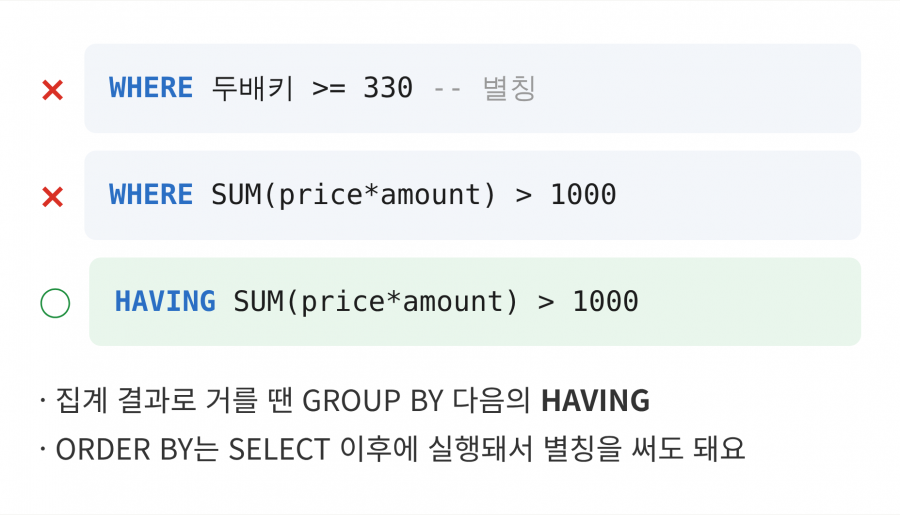
| SELECT mem_id, height*2 AS 두배키 FROM member WHERE 두배키 >= 330 ORDER BY 두배키; |
이 SQL은 WHERE 절에서 오류가 발생합니다. 실행 순서상 WHERE 절은 별칭이 만들어지는 SELECT 절보다 먼저 처리되기 때문입니다. 반면 ORDER BY 절은 SELECT 이후, 사실상 마지막 단계에 실행되므로 별칭을 사용할 수 있습니다.
| SELECT mem_id, SUM(price * amount) AS total FROM buy WHERE SUM(price * amount) > 1000 GROUP BY mem_id; |
같은 이유로 이 SQL도 오류가 발생합니다. WHERE 절은 GROUP BY 이전에 행 단위로 평가되므로 집계 함수를 사용할 수 없습니다. 집계 결과를 조건으로 거르려면 GROUP BY 다음의 HAVING 절을 사용해야 합니다. 예를 들어 '회원별 총 구매 금액이 1000 이상인 회원만 총 구매 금액 내림차순으로 출력'하려면 HAVING SUM(price*amount) >= 1000으로 조건을 걸고, ORDER BY total DESC처럼 집계 표현이나 별칭으로 정렬합니다.
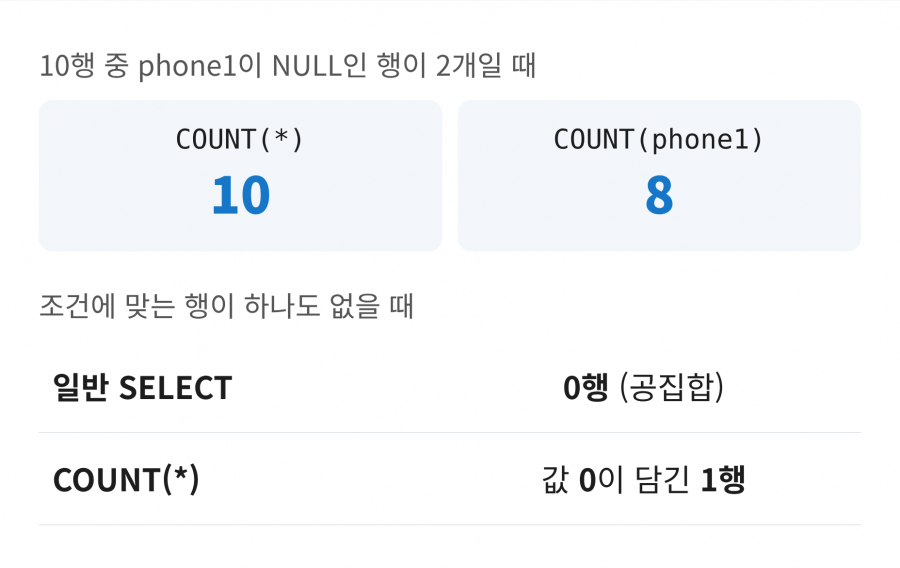
member 테이블이 총 10행이고, 그중 연락처(phone1) 열이 NULL인 행이 2건이라고 가정합니다.
| SELECT COUNT(*), COUNT(phone1) FROM member; |
결과는 10, 8입니다. COUNT(*)는 모든 행의 개수를 세고, COUNT(열_이름)은 해당 열의 값이 NULL인 행을 제외하고 셉니다. 또 조건을 만족하는 행이 하나도 없을 때 일반 SELECT는 0행(공집합)을 반환하지만, COUNT(*) 같은 집계 함수는 대상이 0건이어도 결과 행을 1개 만들어 내며 그 값은 0이 됩니다.
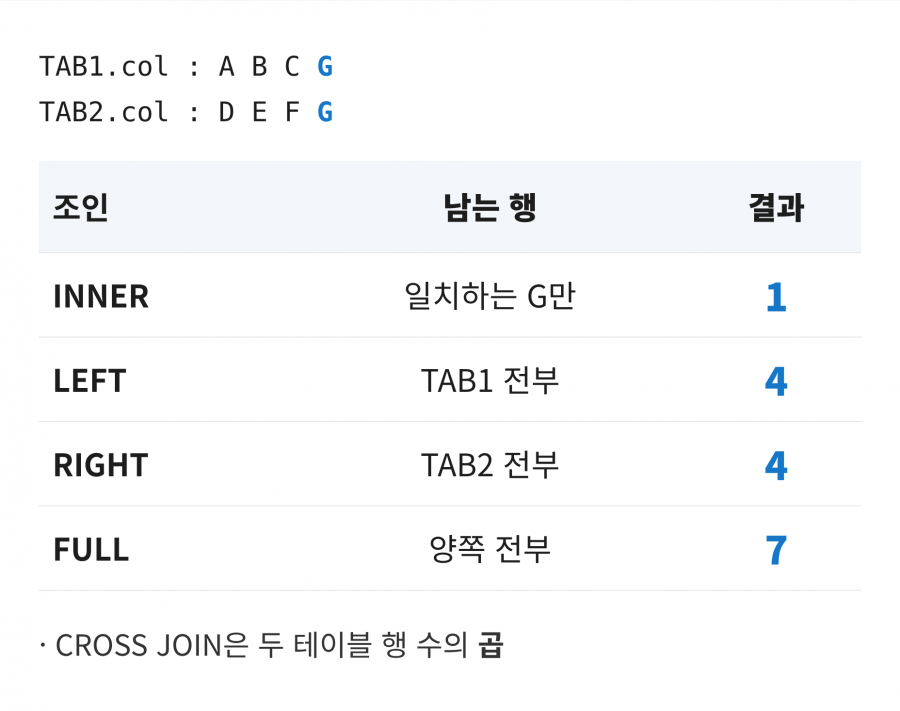
| TAB1.col : A, B, C, G (4행) TAB2.col : D, E, F, G (4행) |
두 테이블의 col 값에 중복이 없고, 조인 조건을 TAB1.col = TAB2.col로 할 때 결과 행 수는 다음과 같습니다. 두 테이블에서 일치하는 값은 G 1건뿐이므로 INNER JOIN은 1행입니다. LEFT OUTER JOIN은 TAB1의 4행을 모두 반환하므로 4행, RIGHT OUTER JOIN은 TAB2의 4행을 모두 반환하므로 4행입니다. FULL OUTER JOIN은 양쪽 테이블의 모든 값을 포함하므로 A, B, C, D, E, F, G 총 7행입니다. 참고로 MySQL은 FULL OUTER JOIN을 직접 지원하지 않으므로 LEFT OUTER JOIN과 RIGHT OUTER JOIN의 결과를 UNION으로 결합하여 구현합니다.
외부 조인은 '짝이 없는 행'을 찾을 때도 쓰입니다. LEFT OUTER JOIN을 했을 때 오른쪽 테이블에 매칭이 없는 행은 오른쪽 테이블의 모든 컬럼이 NULL이 되므로, WHERE B.mem_id IS NULL 조건으로 거르면 '구매 기록이 없는 회원'처럼 짝이 없는 행만 추출할 수 있습니다. 한편 상호 조인(CROSS JOIN)은 모든 행 조합을 반환하므로 결과 행 수가 두 테이블 행 수의 곱이 됩니다.
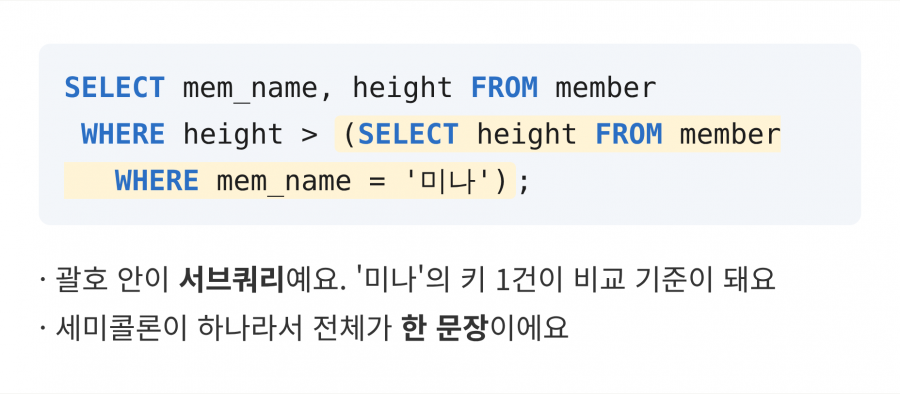
| SELECT mem_name, height FROM member WHERE height > (SELECT height FROM member WHERE mem_name = '미나'); |
SELECT 안에 또 다른 SELECT가 들어간 것을 서브 쿼리(하위 쿼리)라고 합니다. 세미콜론이 하나이므로 전체가 하나의 문장이며, 괄호 안 SELECT의 결과('미나'의 키 1건)가 바깥 쿼리의 비교 기준이 됩니다. 이때 >, = 같은 비교 연산자와 함께 쓰려면 서브 쿼리 결과가 단일 행이어야 합니다.
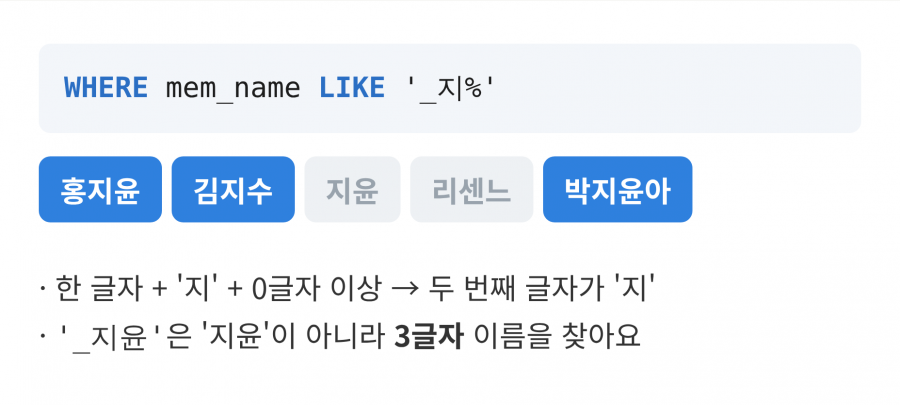
LIKE 연산자에서 %는 0개 이상의 임의의 문자열을, _는 정확히 한 글자를 의미합니다. 예를 들어 mem_name 값이 '홍지윤', '김지수', '지윤', '리센느', '박지윤아'일 때, 이름의 두 번째 글자가 '지'인 회원을 모두 찾는 패턴은 '_지%'입니다. 임의의 한 글자 + '지' + 0글자 이상을 의미하므로 홍지윤, 김지수, 박지윤아가 조회됩니다. 또 와일드카드는 LIKE와 함께 써야 동작합니다. = 연산자에서는 %가 와일드카드가 아니라 문자 그대로 비교되므로, '연구소'로 끝나는 이름을 찾으려면 WHERE mem_name LIKE '%연구소'로 작성해야 합니다.
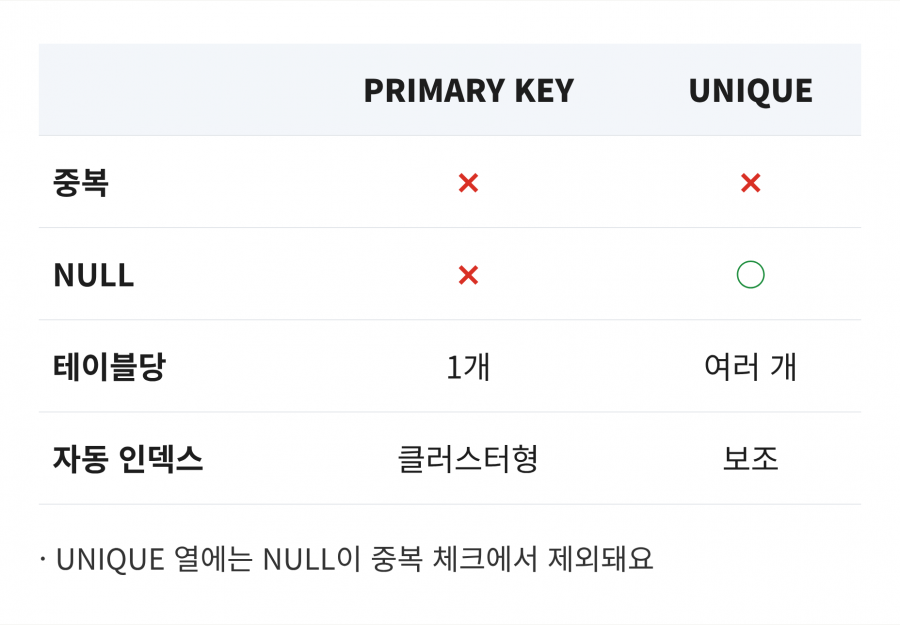
| CREATE TABLE T1 ( C1 INT PRIMARY KEY, C2 INT NOT NULL, C3 INT UNIQUE ); INSERT INTO T1 VALUES (1, 1, 1); -- 입력 완료 |
이 상태에서 INSERT INTO T1 VALUES (2, 2, NULL);은 정상 입력됩니다. UNIQUE는 PK와 달리 NULL을 허용하며, NULL은 중복 체크에서 제외되기 때문입니다. 반면 C1에 1을 다시 넣으면 PK 중복으로, C2에 NULL을 넣으면 NOT NULL 위반으로, C3에 기존 값 1을 넣으면 UNIQUE 중복으로 에러가 발생합니다. PRIMARY KEY는 '중복 없음 + NULL 없음'을 보장하며 자동으로 클러스터형 인덱스가 생성되고, UNIQUE는 한 테이블에 여러 개 설정할 수 있으며 자동으로 보조 인덱스가 생성됩니다.
위 6가지는 SQL의 기본 동작 원리를 점검하는 개념입니다. 실제 SQLD 합격을 목표로 한다면 다음 영역을 추가로 학습해야 합니다.
또 SQLD는 특정 DBMS 하나에 한정해서 출제되지 않습니다. 따라서 LIMIT, AUTO_INCREMENT, @변수, DELIMITER 같은 MySQL 전용 문법은 시험에 그대로 나온다고 보기보다, 그 문법이 설명하는 SQL 개념을 중심으로 이해하는 것이 좋습니다. 시험이 가까울수록 새로운 범위를 넓히는 것만큼, 이미 안다고 생각한 기본 개념을 다시 확인하는 일이 중요합니다.
위 컨텐츠는 우재남 저자의
『혼자 공부하는 SQL with AI』를 재구성하여 작성되었습니다.
 0


 0
댓글