 신상윤
3시간 전
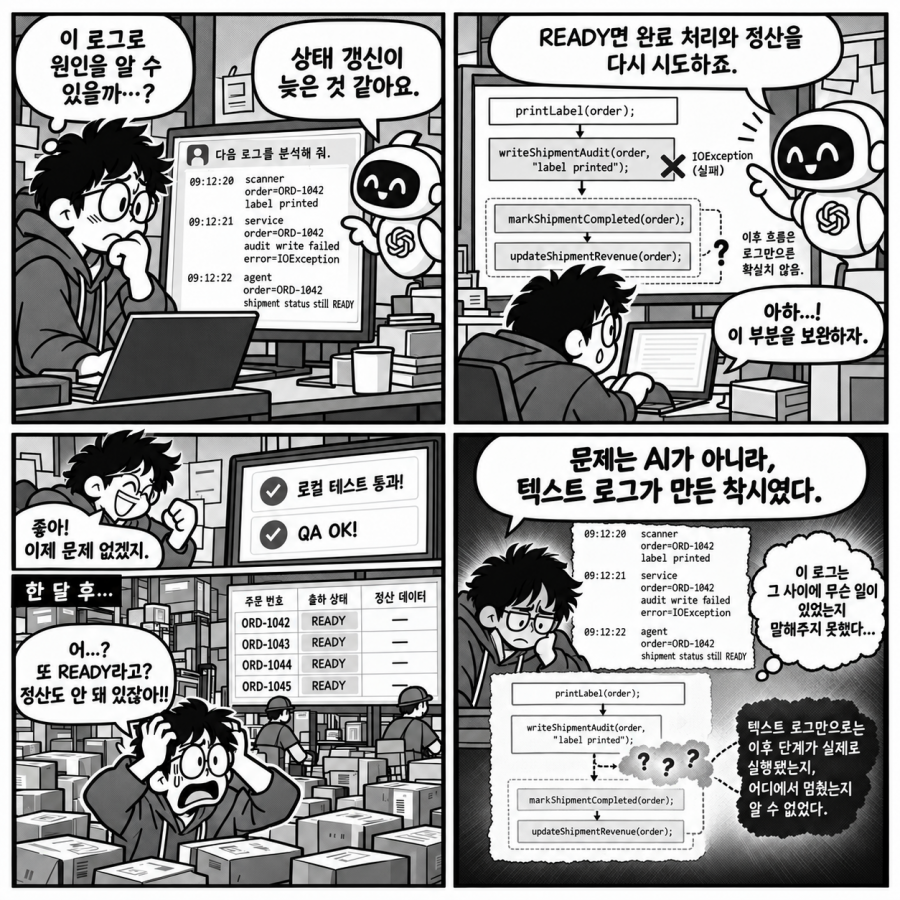
장애 로그를 AI에게 붙여 넣고 원인을 물으면 그럴듯한 답이 돌아옵니다. 그 답이 틀렸다는 사실은 대개 같은 장애가 다시 터진 뒤에야 드러납니다. 한 물류 시스템의 출고 장애는 AI가 로그를 잘못 읽은 것이 아니라, 로그가 애초에 답을 담고 있지 않았다는 사실을 보여줍니다.
장애 현상은 송장 라벨이 인쇄됐는데 출고 완료 상태가 갱신되지 않았다는 것이었습니다. AI가 전달받은 텍스트 로그는 다음 세 줄입니다.
09:12:20 scanner    order=ORD-1042 label printed
09:12:21 service    order=ORD-1042 audit write failed error=IOException
09:12:22 agent      order=ORD-1042 shipment status still READY
AI는 로그의 단서를 코드베이스의 호출 흐름과 엮어 추적합니다. 해당 출고 처리는 라벨 출력, 감사 로그 작성, 상태 갱신, 정산 갱신 순서로 함수를 호출합니다.
printLabel(order);
writeShipmentAudit(order, "label printed");
markShipmentCompleted(order);
updateShipmentRevenue(order);
로그상 라벨 출력 후 감사 로그 작성이 실패했고, 1초 뒤 에이전트가 확인한 상태는 여전히 READY였습니다. AI는 예외가 내부에서 처리되어 다음 단계로 넘어갔지만 상태 반영이 늦어졌다고 추론했고, 상태 갱신 실패나 지연 반영을 원인으로 지목했습니다. 수정 방향은 상태가 READY로 남아 있으면 완료 처리와 정산 갱신을 다시 시도하는 로직이었습니다.
수정된 코드는 로컬 테스트와 QA를 통과하고 배포되었습니다. 한 달 뒤 출고량이 급증한 날, 같은 장애가 다시 발생했습니다. 물류 센터 바닥에는 송장이 붙은 박스가 쌓였지만, 시스템의 업무 상태는 READY에 머물러 정산 데이터가 생성되지 않았습니다. 테스트 환경에서는 파일 쓰기 권한 충돌이나 일시적인 자원 부족 같은 예외 상황이 쉽게 재현되지 않습니다. 결국 예외 경로는 확인하지 못한 채 정상 경로만 검증하고 배포한 셈이었습니다. 문제는 AI의 지능이 아니라 텍스트 로그가 만든 착시였습니다.
앞의 세 줄 로그만으로는 상태 갱신 함수(markShipmentCompleted) 내부에서 실패가 일어났는지, 예외 때문에 상태 갱신 함수에 도달조차 못 했는지 구분할 수 없습니다. 텍스트 로그의 한계는 기록되지 않은 사건을 증명할 수 없다는 데 있습니다. 코드가 특정 분기를 타지 않아 로그가 남지 않은 것인지, 실행 도중 예외로 흐름이 끊겨 기록되지 않은 것인지 텍스트만으로는 알 수 없습니다.
실제 문제는 감사 로깅 함수(writeShipmentAudit)에서 시작되었습니다. 이 함수가 IOException을 내부에서 처리하지 않고 상위로 던지면, 그다음 비즈니스 함수는 호출되지 않습니다. 운영 환경에서는 다른 프로세스가 감사 로그 파일을 잠시 점유하거나 쓰기 권한이 일시적으로 막히는 것만으로도 이런 예외가 발생할 수 있습니다. 동일한 텍스트 로그 뒤에 숨어 있던 두 실행 경로를 나란히 놓으면 차이가 드러납니다.
| 단계 | AI가 추론한 경로 | 실제 발생한 경로 |
| 1 | printLabel 성공 | printLabel 성공 |
| 2 | writeShipmentAudit 실패, 예외는 내부에서 격리 | writeShipmentAudit에서 IOException 발생 |
| 3 | markShipmentCompleted 호출 | IOException이 상위 함수 processShipment로 전파 |
| 4 | markShipmentCompleted 내부 실패 또는 지연 반영 | markShipmentCompleted 미도달(호출되지 않음) |
| 5 | agent가 상태 READY 확인 | agent가 상태 READY 확인 |
두 경로의 진짜 차이는 화면에 찍힌 에러 메시지가 아니라, 함수가 어디까지 실행되었는지를 나타내는 호출 경계에 있습니다. 경험 많은 엔지니어라면 콜 스택을 보면 되지 않느냐고 반문할 수 있습니다. 콜 스택은 예외가 발생한 위치와 당시의 호출 관계를 보여줍니다. 그러나 AI의 오판을 막으려면 예외 발생 뒤 다음 비즈니스 함수가 호출되었는지까지 코드베이스와 대조할 수 있어야 합니다. 그래야 AI가 상태 갱신 실패와 상태 갱신 미도달을 추론 없이 구분합니다. 추론은 엔지니어링에서 독입니다.
이 대조에 필요한 것이 실행 트레이스입니다. 실행 트레이스는 비즈니스 함수의 시작과 종료, 예외 발생을 기록하는 운영 데이터입니다. 같은 장애를 실행 트레이스로 기록하면 ORD-1042의 실행 흐름은 다음과 같이 남습니다(cid는 A1로 줄여 표기).
{"cid":"A1","func":"processShipment","event":"start","params":{"mode":"commit"}}
{"cid":"A1","func":"printLabel","event":"end","result":"success"}
{"cid":"A1","func":"writeShipmentAudit","event":"error","error":"IOException"}
{"cid":"A1","func":"processShipment","event":"error","error":"IOException"}
writeShipmentAudit에서 발생한 예외는 내부에서 처리되지 못하고 processShipment까지 전파됐습니다. 실행 트레이스가 있으면 AI는 "상태 갱신이 실패했다"와 "상태 갱신 함수에 아예 도달하지 못했다"를 추론이 아니라 기록으로 구분할 수 있습니다. 이 트레이스를 입력받은 AI는 이번 장애를 예외 전파로 인한 상태 갱신 미도달로 판정합니다.
신뢰할 수 있는 AI 루프를 구축하는 첫 단계는 더 높은 성능의 최신 모델을 고르거나 새로운 외부 도구를 덧붙이는 것이 아니라, 제품의 운영 기록에 AI가 사후 디버깅할 수 있는 실행 트레이스를 심는 일입니다. AI에게 코드베이스는 진입 가능한 모든 경로를 보여주는 지도이고, 텍스트 로그는 그 길 위에서 관찰된 파편적인 사건입니다. 실행 트레이스는 이번 실행이 실제로 어느 길을 통과했는지 증명하는 대조 가능한 증거입니다.
실행 트레이스로 원인을 찾아 코드를 수정했고, 새로 추가한 재현 테스트도 통과했습니다. 그러나 배포 한 달 뒤, 월말 정산 화면에서 숫자가 어긋났습니다.
출고 완료 건수: 12,840건
정산 반영 건수: 12,833건
차이: 7건
미청구 매출: 42,800,000원
현장 스캐너에는 모든 작업이 출고 완료(COMPLETED)로 남아 있었지만, 정산 에이전트에는 7건의 정산 전송 이벤트가 전달되지 않았습니다. 물건은 이미 고객에게 전달됐고, 4,280만 원이 월말 청구 대상에서 빠졌습니다. 재현 테스트와 QA를 통과한 코드였지만, AI가 수정 과정에서 기존 정산 연계 로직을 깨뜨렸고 이를 확인할 회귀 게이트가 없었습니다.
사고 이후 출고 완료 건수와 정산 반영 건수가 일치하는지 확인하는 테스트를 회귀 게이트에 추가했습니다. 같은 코드 변경을 다시 검증하자 920건 중 1건이 실패했고, 이번에는 배포 전에 루프가 멈췄습니다. AI가 더 똑똑해진 것이 아니라, 결함이 고객에게 도달하기 전에 하네스가 루프를 멈추도록 검증 구조가 바뀐 것입니다.
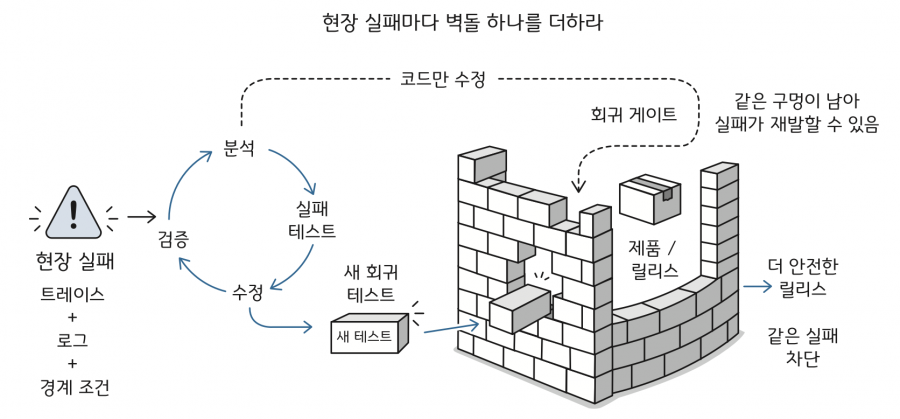
AI는 하루에도 수천 줄의 코드를 생산합니다. 그때마다 기존 수천 개의 테스트 시나리오가 깨지지 않았는지 사람이 손으로 확인하는 방식은 루프가 아니라 두더지 게임입니다. 회귀 게이트가 없으면 빨라진 개발 속도는 곧 결함 전파 속도가 됩니다. 수십 배 빨라진 개발 루프에서 엔지니어의 역할은 회귀 테스트를 수행하는 사람이 아니라 회귀 게이트를 설계하는 사람으로 바뀝니다. 게이트가 없는 루프에서는 신규 테스트 통과가 곧 배포 신호가 됩니다. 게이트가 있는 루프는 기존 제품 약속까지 다시 검증하고, 실패하면 루프 자체가 멈춥니다.
신규 테스트는 새로 발견한 구멍을 막고, 회귀 게이트는 이미 지키고 있던 벽이 무너지지 않았는지 확인합니다. 벽이 없는 상태에서 구멍 하나를 막았다고 건물이 안전해지지는 않습니다.
게이트를 세운 뒤에도 남는 문제가 있습니다. 회귀 게이트가 실패하면 AI는 곧바로 프로덕션 코드를 고치려 들고, 그러면 루프가 망가집니다. 회귀 게이트에 실패 원인을 판정하는 엄격한 순서가 필요한 이유입니다.
실행 트레이스와 회귀 게이트는 AI를 더 똑똑하게 만드는 장치가 아닙니다. AI가 틀렸을 때 그 사실이 고객보다 먼저 드러나게 만드는 구조입니다. 어느 함수까지 계측할지, 게이트가 실패했을 때 무엇부터 의심할지는 결국 엔지니어가 설계해야 할 몫으로 남습니다.
위 컨텐츠는 신상윤 저자의
『AI 루프를 설계하라』를 재구성하여 작성되었습니다.
 0



 0
댓글