 신진수
21시간 전
회의에 들어갔는데 이미 결론이 정리된 문서가 올라와 있었습니다. 숫자는 정확해 보였고 논리도 매끄러웠습니다. 마지막 장에는 권고까지 적혀 있었죠. 사람은 읽고 승인만 하면 되는 상태였습니다. 그 문서를 만든 건 바로 AI였습니다.
지난 글(바로가기) 끝에서 이런 질문을 남겼습니다.
해당 액션을 그대로 승인했다면, 과연 그 결정은 누가 내린 걸까요?
지금 이 장면에서 바로 그 질문이 생깁니다. 답하기 전에 그 문서에 적힌 숫자부터 보겠습니다.
요즘 제가 받는 요청의 성격이 달라졌습니다. 예전에는 "숫자 좀 뽑아주세요"가 대부분이었다면, 지금은 "제가 뽑아봤는데 이 숫자 맞나요?"가 훨씬 많습니다. 문제는 대체로 그 숫자가 맞지 않다는 겁니다.
그 문서에 적힌 귀환 유저 숫자만 해도 그렇습니다. 귀환 유저의 기준부터 보는 관점과 조직에 따라 다를 수 있습니다. 지난달 회의에서 그 기준을 바꿨더라도 테이블에는 맥락과 흔적이 잘 남지 않고요. 그 차이를 아는 사람은 쿼리를 짤 때 반영하지만, AI는 따로 알려주지 않으면 컬럼 이름만 보고 짭니다. 문법이 완벽한 쿼리가, 완벽하게 틀린 답을 내놓는 겁니다.
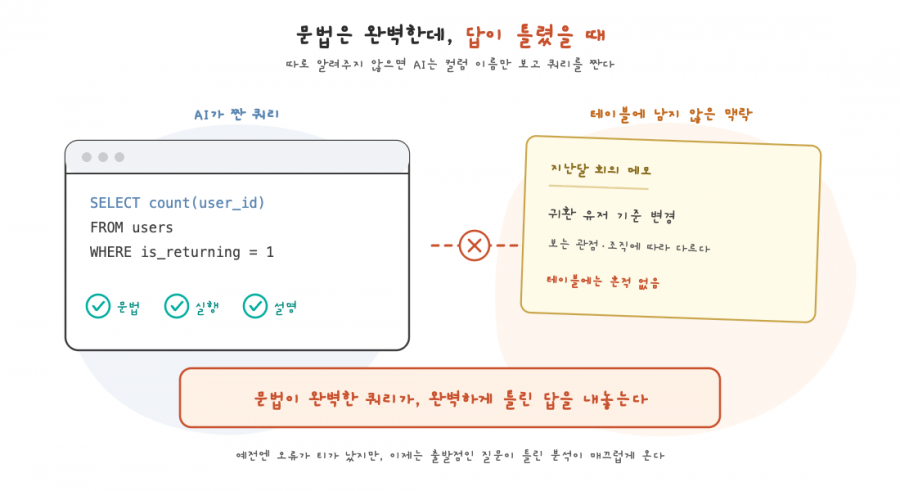
예전에는 잘못된 분석이 수치 오류나 어색한 문장으로 티가 났습니다. 이제는 코드도 멀쩡히 돌아가고 설명도 매끄러운데, 출발점인 질문이 틀린 분석이 자주 제 앞에 옵니다.
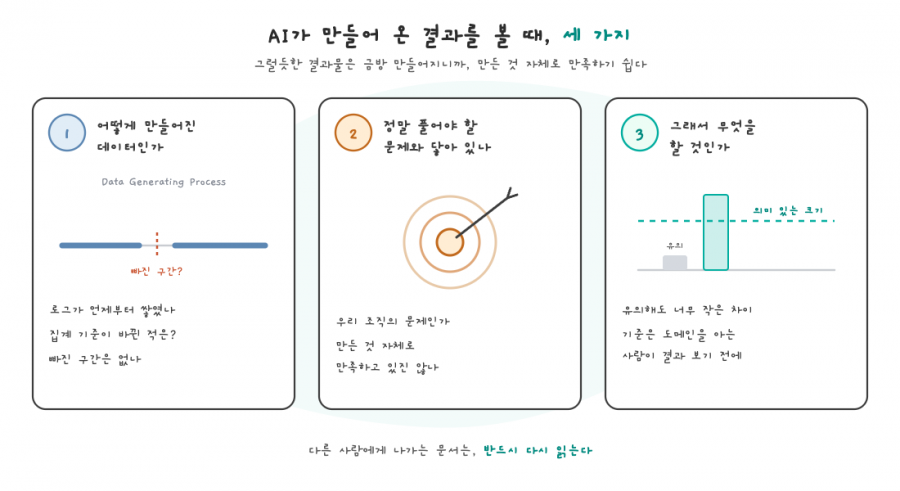
그래서 저는 다른 사람에게 나가는 문서는 반드시 다시 읽습니다. 다만 이건 저 혼자 조심해서 될 일이 아니더라고요. 누구나 데이터를 꺼내 볼 수 있게 되면서, 같은 지표를 같은 정의로 보자고 합의하는 일 자체가 병목이 됐습니다.
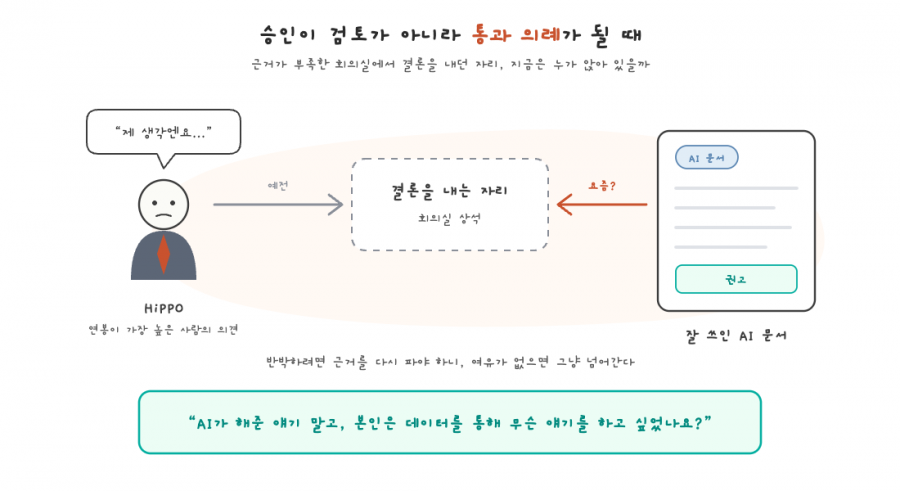
더 걱정스러운 건 그다음입니다. 잘 쓰인 문서에 반박하려면 근거를 다시 파야 하는데, 시간적 여유가 없거나 그럴 이유를 느끼지 못하면 그냥 넘어가게 됩니다. 사실 모두가 AI가 만들어준 결과물을 꼼꼼하게 QA 해야하는데, 그렇지 않고 승인이 검토가 아니라 통과 의례가 되는 겁니다.
사실상 결론을 정해두고 확인용으로 실험을 돌릴 때와 같은 구조죠. 데이터와 근거 자료가 부족한 회의실에서는 결국 연봉이 가장 높은 사람의 의견이 결론을 냅니다(HiPPO, highest paid person's opinion). 요즘은 그 자리를 잘 쓰인 AI 문서가 이어받고 있는 건 아닌지 자주 스스로 묻게 됩니다.
주니어 실무자나 동료가 AI 결과를 그대로 가져오면, 저는 분석 방법보다 이것부터 묻습니다.
"AI가 해준 얘기 말고, 본인은 데이터를 통해 무슨 얘기를 하고 싶었나요?"
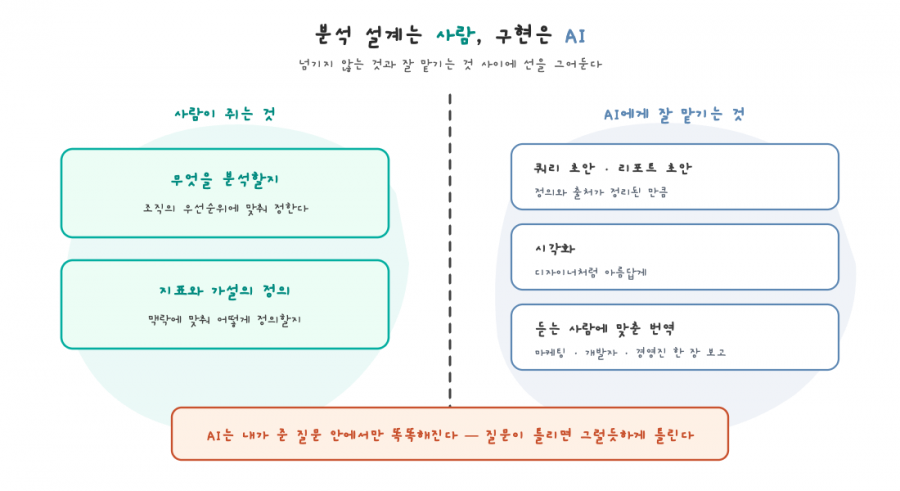
그렇다고 AI를 안 쓸 수는 없습니다. 개인적으로 저는 회사 안밖으로 정말 많이 그리고 잘 쓰고 있어요. 다만 분석 설계는 사람, 구현은 AI라는 선은 그어두고 일합니다. 넘기지 않는 건 두 가지입니다.
AI는 제가 준 질문 안에서만 똑똑해지고, 질문이 잘못 되었고 맥락 주입이 제대로 되지 않았다면, 아주 그럴듯하게 틀린 답을 주거든요.
그래서 저는 AI가 만들어 온 결과를 검토할 때는 세 가지를 봅니다.
반대로 잘 맡기는 영역도 분명합니다. 저는 시각화를 디자이너처럼 아름답게 만드는 데 약한데, AI는 훨씬 잘 만들어줍니다. 번역도 언어를 옮기는 것만이 아니라, 듣는 사람에 맞게 옮기는 일까지요.
같은 분석 결과라도 마케팅 팀에 설명할 때, 개발자에게 설명할 때, 경영진에게 한 장으로 보고할 때 필요한 문장이 전부 다릅니다. 분석가 시간의 상당 부분이 사실 설명에 들어가는데, AI가 벌어주는 시간이 여기서 제일 큽니다.
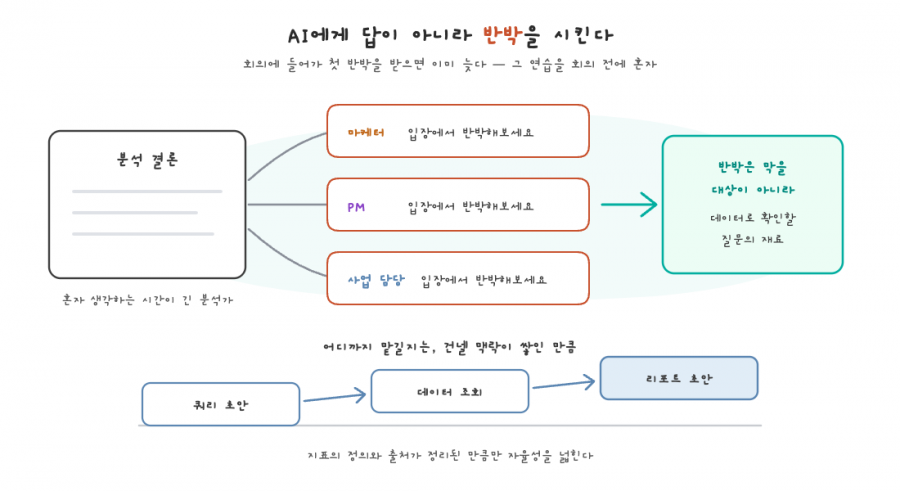
요즘 가장 많이 쓰는 용도는 따로 있습니다. 분석 결과를 정리한 다음 "이 결론을 볼 사람이 마케터, PM, 사업 담당자인데 각자 입장에서 반박해보세요"라고 시키는 거죠. 분석가는 결론이 나올 때까지 혼자 생각하는 시간이 길고, 그동안 중간 공유를 하지 않는 이상 다른 직무의 실무자가 반박하기 쉽지 않습니다. 회의에 들어가 첫 반박을 받으면 그땐 이미 늦고요.
AI한테 답을 물어보는 게 아니라, 오히려 반박과 비판을 시키는 겁니다. 반박은 막을 대상이 아니라, 데이터로 확인할 수 있는 질문으로 바꿔야 할 재료입니다. 이제는 그 연습을 회의 전에 혼자 해볼 수 있게 됐습니다.
어디까지 맡길지는 AI에게 건넬 맥락이 얼마나 쌓였느냐로 정합니다. 쿼리 초안을 받는 데서 시작해 데이터 조회, 리포트 초안까지, 그 지표의 정의와 출처가 정리된 만큼만 자율성을 넓혀가는 식이죠.
조금 불편한 이야기를 해야겠습니다. AI가 초안을 쓰는 구조에서는 책임이 흐려지기 쉽습니다. 결과가 나쁘면 "분석이 그렇게 나왔다"는 말이 나오거든요. 저는 그 말이 조직에 퍼지기 시작하면 위험하다고 봅니다. 아무도 책임지지 않는 결정이 늘어난다는 뜻이니까요.
그래서 처음 질문에 대한 제 답은 이렇습니다. 그대로 승인했다면, 그 결정은 승인한 사람이 내린 것입니다. 도구가 무엇을 만들었든, 결정에는 언제나 이름이 붙어야 합니다.
그렇다고 승인한 사람에게만 책임을 지우자는 말은 아닙니다. 제안한 쪽의 책임은 그 숫자가 무엇을 전제하고 있는지 드러내는 것이고, 결정한 쪽의 책임은 그걸 검토하는 것입니다. 둘 중 하나라도 비면 그 결정은 주인이 없어지죠. 사람을 탓하자는 것도 아닙니다. 오히려 반대입니다. 누가 어떤 근거로 판단했는지 남아 있어야, 틀렸을 때 어디서 어긋났는지 되짚을 수 있습니다. 틀리는 것이 부끄럽지 않은 조직일수록 이름을 붙이는 데 거리낌이 없고요. 책임을 묻는 것과 벌하는 것은 다르니까요.
그럼 그 이름과 판단은 어디에 남길까요. 과거 기록을 다시 꺼내 보면, 결론은 있는데 그 결정이 어떤 배경에서 정해졌는지, 중간에 바뀌었다면 언제 왜 바뀌었는지가 없는 경우가 많았습니다. 투자 일지에 손익만 적고, 왜 샀는지와 그 판단이 결국 맞았는지는 빠뜨린 셈이죠. 지금은 무엇을 분석했고, 무엇을 발견했고, 무엇을 하자고 했고, 그래서 제품에서 무엇이 바뀌었는지가 하나로 이어지도록 남깁니다. 예전에는 "지난번에 그거 어떻게 됐죠?"라는 질문에 리포트를 다시 열어봐야 했는데, 지금은 제안 하나를 누르면 근거와 결정과 결과가 따라옵니다.
가장 도움이 된 건 의외로 단순한 습관이었습니다. 개별 DM이 아니라 채널에 의사결정을 남긴 것이었어요. 그때는 그냥 투명하게 일하자는 뜻이었는데, 그 기록들이 나중에 조직의 기억이 됐고, 지금은 AI와 일할 때 가장 값진 맥락이 되고 있습니다.
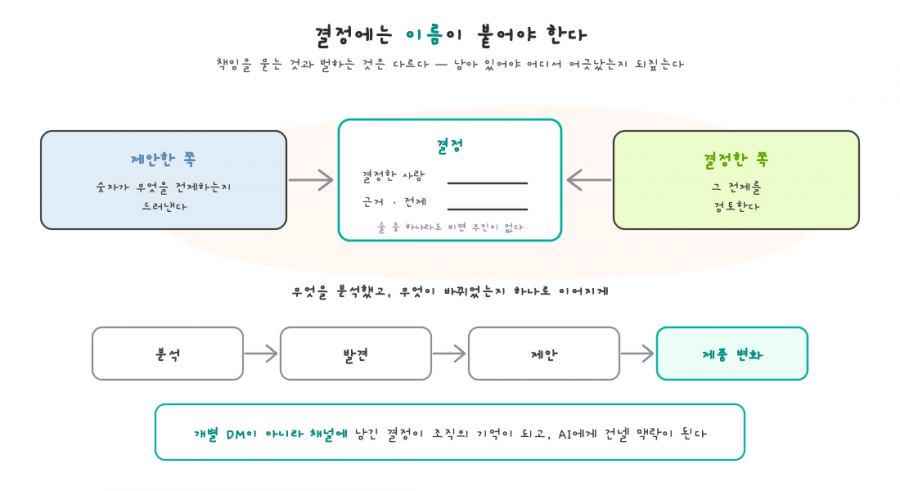
판단의 근거를 남기는 습관이 있는 조직은 AI를 쓸 준비가 이미 되어 있는 셈입니다. 기록이 곧 맥락이라, 남긴 만큼 AI에게 넘길 수 있는 일도 늘어나죠. 반대로 회의가 끝나면 결정도 함께 사라지는 조직은 아무리 좋은 도구를 들여와도 건넬 맥락이 없습니다.
실험하는 조직을 만들려고 시작한 일이었는데, 돌아보니 곁에서 함께 자란 건 판단이 기록으로 남는 조직이었습니다.
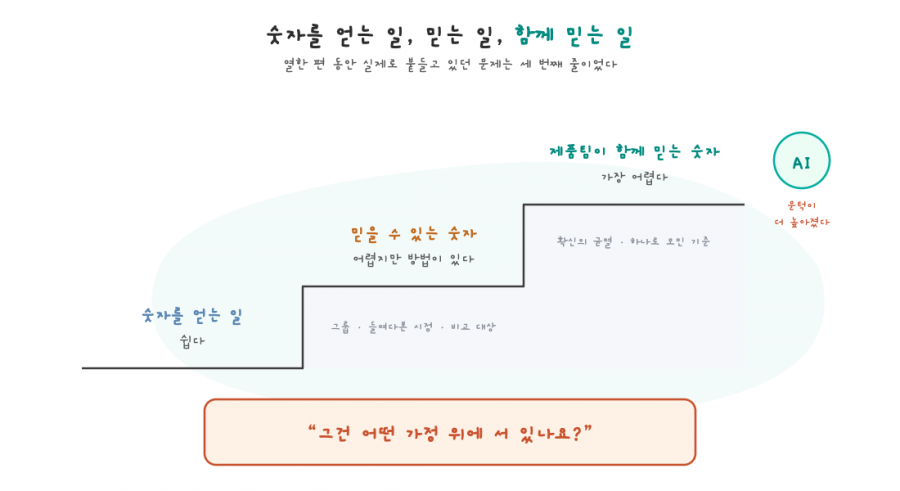
이 연재를 시작할 무렵 저는 숫자를 얻는 건 쉽지만, 믿을 수 있는 숫자를 얻는 건 어렵다고 생각했습니다. 그게 결론인 줄 알았는데, 열한 편을 쓰는 동안 제가 실제로 붙들고 있던 문제는 그다음 줄이었습니다.
Getting numbers is easy. But getting numbers you can trust is hard. And getting numbers your product team can trust is the hardest of all.
앞의 두 줄은 『Trustworthy Online Controlled Experiments』의 문장을 빌린 것이고, 마지막 줄은 이 연재를 쓰며 제가 덧붙인 것입니다.
첫 줄은 따로 증명할 필요가 없었습니다. 회의마다 다들 자기 숫자를 들고 왔으니까요. 두 번째 줄, 믿을 수 있는 숫자를 만드는 일은 어렵지만 방법이 있는 문제였습니다. 그룹이 제대로 나뉘었는지, 결과를 언제 들여다봤는지, 실험이 막혔을 때 무엇과 비교할지. 순서와 기준이 있고, 결과를 보기 전에 합의해두면 지킬 수 있는 영역이었습니다.
정작 오래 걸린 건 세 번째 줄이었습니다. 한 번의 실험이 누군가의 확신에 균열을 내고, 팀마다 다르던 기준이 하나로 모이고, 결국 가장 높은 사람의 아이디어도 실험 앞에서는 가설 하나로 다뤄지기까지. 쓰고 보니 이 연재의 대부분은 숫자를 만드는 법이 아니라, 그 숫자를 함께 믿게 되기까지의 이야기였습니다.
AI 시대에 이 세 번째 줄은 더 어려워졌다고 생각합니다. 숫자를 얻는 일은 더 쉬워졌고 그럴듯한 숫자는 많아졌으니, "우리가 함께 믿을 수 있는가"의 문턱은 오히려 높아졌습니다. 분석가의 자리도 옮겨가고 있습니다. 예전에는 쿼리를 짜고 제품을 분석할 줄 아는 사람이 귀했다면, 이제는 이 지표가 무엇을 뜻하는지 정의하고 조직이 그 정의에 합의하도록 이끄는 사람이 귀합니다. 쿼리 기술보다는 도메인 이해와 커뮤니케이션의 영역이고, 당분간 AI가 대신하기 가장 어려운 부분이기도 합니다.
한때는 데이터 분석가가 필요 없는 날을 만드는 게 이 일의 끝이라고 생각했습니다. 지금 보면 사라지는 건 숫자를 대신 꺼내 주는 일이지, 분석가가 아닙니다.
마지막으로, 이 시리즈를 쓰는 동안 뿌듯함보다 자주 든 생각은, 제가 있는 조직이 실험 조직이 되려면 아직 한참 멀었다는 것이었어요.
데이터로 이야기하는 방식은 어느 정도 자리 잡았어도, 실험을 가로막는 조직 문화, 기술, 정책이라는 세 갈래의 벽은 제가 일하는 곳에서 거의 매번 동시에 서 있습니다. 그중 조직 문화는 정말 쉽게 바뀌지 않더라고요.
이 연재는 조직이 실험의 필요를 자각하는 데서 실험이 몸에 배는 데까지, ABCDE 다섯 단계를 차례로 따라왔지만, 현실에서 순서대로만 밟은 적은 없었습니다. 어려운 건 늘 각 칸이 아니라 칸과 칸 사이였고, 그 틈에서 가장 많이 미끄러진 건 저였습니다. 한 팀에서 된 게 다른 팀에서는 안 됐고, 사람이 바뀌면 쌓아둔 것이 다시 뒤로 밀렸습니다.
이 시리즈는 다 이룬 사람의 기록이 아니라, 아직 가는 중인 사람의 중간 보고에 가깝습니다. 요즘은 적용 시점을 일부러 어긋나게 잡아 비교 대상을 미리 확보해두는 것부터 다시 시도하고 있습니다. 거창한 플랫폼이 아니라 그런 작은 것들이요.
그래도 이 연재를 마치며 첫 글의 질문에는 다시 답할 수 있게 됐습니다. 데이터가 많은데, 왜 결정의 순간엔 망설여질까. 그때는 “따져 물을 도구가 없어서”라고 썼습니다. 틀린 말은 아니었지만, 도구가 생긴 뒤에도 망설임은 남았습니다. 지금은 이렇게 답하겠습니다.
숫자가 부족해서가 아니라, 그 숫자를 나 말고 아무도 믿지 않아서였습니다.
대시보드를 더 만들고 실험 건수를 늘려도 해결되지 않았던 이유가 여기에 있었습니다. 좋은 AI를 들여와도 마찬가지일 겁니다. 전부 숫자를 더 잘 뽑는 일이지, 함께 믿게 만드는 일은 아니니까요. 데이터 분석가의 일은 숫자를 뽑는 게 아니라 결정을 돕는 것이고, 돕는 일은 원래 혼자 할 수 없습니다.
질문 하나가 회의실 공기를 바꾸는 걸 여러 번 봤습니다. 그러니 내일 회의에서 딱 하나만 해보시면 좋겠습니다. 처음 이야기한 그 문서처럼 결론이 이미 정리되어 올라와 있다면, 그게 사람이 만든 것이든 AI가 만든 것이든 이렇게 한 번 물어봐 주세요.
"그건 어떤 가정 위에 서 있나요?"
우리 제품팀이 함께 믿을 수 있는 숫자는 그 질문 하나에서 시작됩니다. 긴 여정을 함께해 주셔서 고맙습니다.
함께 보면 좋은 강의
『데이터 실무자의 사고력 강화 : AI 인과추론 실무』는 크래프톤 데이터 분석가 신진수님과 함께 상관관계와 인과관계를 구분하는 사고 방식, 그리고 실무에서 실제로 활용되는 실험과 판단의 기준을 다루는 강의입니다.
단순히 분석하는 것을 넘어, “무엇이 무엇을 움직였는가”를 고민해보고 싶다면 추천드립니다.

?『데이터 실무자의 사고력 강화 : AI 인과추론 실무』 보러 가기
 0


 0
댓글