독자리뷰
학구열을 높여주는 책
tjqn***
2020-10-25

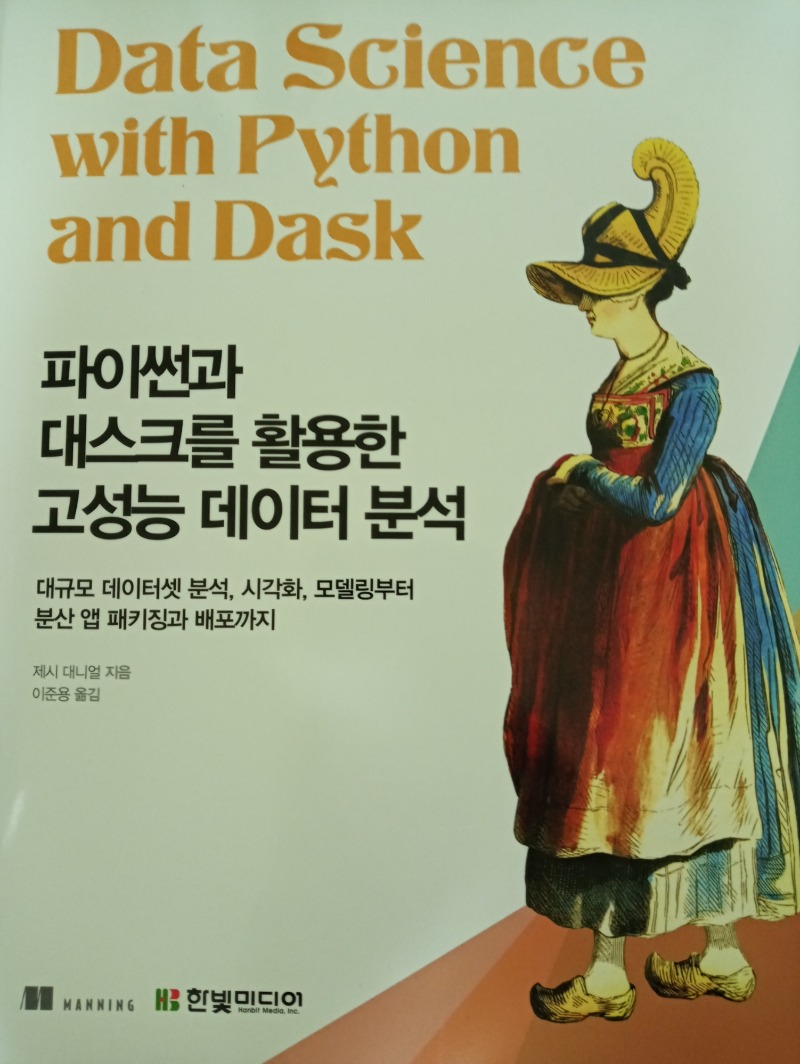
파이썬과 대스크를 활용한 고성능 데이터 분석
대스크를 활용한 데이터 정리에서 배포에 이르기까지 데이터 과학의 일반적인 워크플로를 소개한다. 먼저 확장 가능한 컴퓨팅을 익히고 이를 대스크가 어떤 방식으로 활용하는지 살펴본다. 이어서 다양한 실제 데이터셋을 준비하고 분석, 시각화, 모델링하는 과정에서 대스크로 일반적인 데이터 과학 작업을 수행하는 방법을 실용 예제로 제공한다. 마지막으로 AWS에 자신만의 대스크 클러스터를 배포해 분석 코드를 확장하는 과정을 단계별로 안내한다.
- 저자 : 제시 대니얼
- 번역 : 이준용
- 출간 : 2020-10-05
장점
1. 책을전체적으로 보았을 때 문제정의-> 데이터 수집-> 데이터정리-> 탐색적 분석-> 가설 설정과 검정-> 모델 구축과 검정-> 모델 배포와 모니터링 과정을 장으로세분화하여 나누어 부족한 부분에 대하여 복습하기에 좋음
2. 데이터분석을 위해 보통 파이썬에서 판다스를 사용하지만 iris같은 소규모 데이터에 적합하며 규모가 큰 데이터셋일 경우 판다스의 경우 비효율적이므로 이를 해결하기 위해 대스크를 통하여 큰 데이터셋을 분할하여 병렬로 처리하는 법을 예시와 함께 과정을 설명을해주어 이걸 왜 이렇게 하는지에 초점을 맞춰주어 이해가 잘됨
후기
1. 이책을 읽기 전에는 kaggle에서 csv나 스크래핑 하여정규화 하는 방식으로 데이터를 읽었었는데 책에서는 RDBS, HDFS, S3, 파케이 형식으로 다양하게읽는 법을 알려주며 대스크 프레임워크를 데이터를 다루는 법 시각화 하는 법 등 읽다 보면 내가 배웠던 것은 소규모의 데이터를 다루는 법에 대하여배웠구나 싶어 학구열을 더 높여 주는 책인 것 같다.