독자리뷰
[책 리뷰] 딥러닝과 바둑
jin***
2020-06-22

딥러닝과 바둑
2016년 세상을 공포와 충격에 빠트린 알파고는 알파고 제로에 완패를 당해 쓸슬히 퇴역했다. 이런 알파고의 드라마틱한 역정을 지켜본 개발자라면 한 번쯤 인공지능 바둑봇을 만들고 싶다는 막연한 생각을 해봤을 것이다.
- 저자 : 막스 펌펄라 , 케빈 퍼거슨
- 번역 : 권정민
- 출간 : 2020-06-01
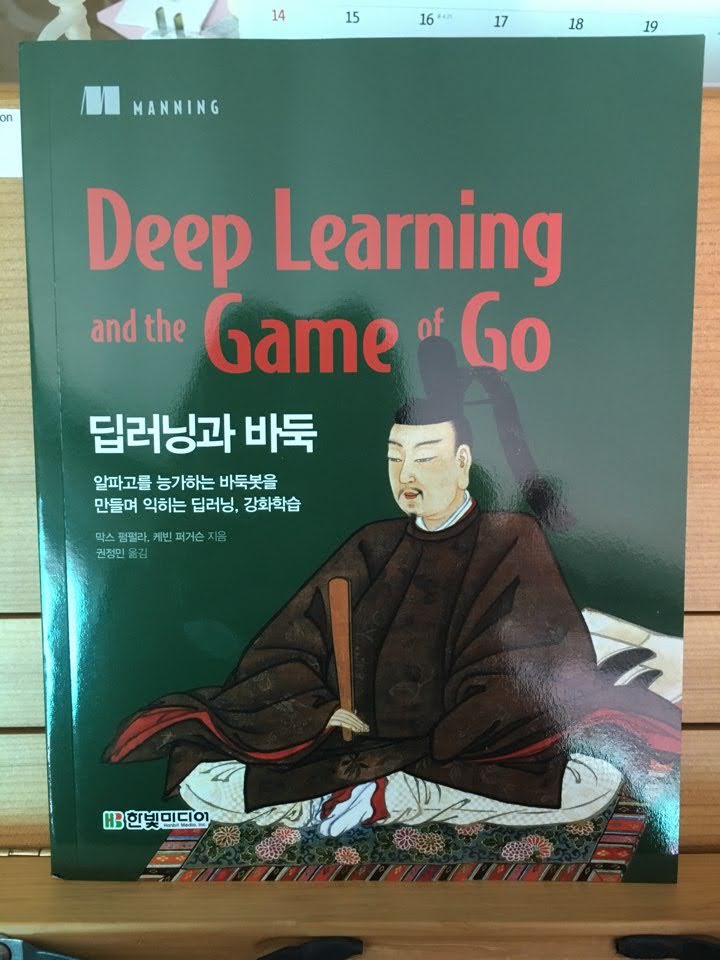
이번에 리뷰할 책은 Max Pumperla의 딥러닝과 바둑이다. 참고로 저자인 Max는 개인 블로그를 운영중인데 (https://maxpumperla.com/projects/) 최근 프로젝트들을 보면 딥러닝의 deployment에 대한 프로젝트들도 활발히 진행중인 것으로 보인다. 이전에 머신러닝 프로젝트 & 연구들은 더 나은 모델들을 찾고 training 하는데에 집중했다면, 최근의 머신러닝은 이미 잘 알려진 모델들을 기반으로 실제 문제에 적용하고, 해당 솔루션을 보편화 시키는데에 많이 집중하고 있다. 최근에 핫한 분야인 Neuro Architecture Search를 기반으로 구글은 AutoML을 서비스하고있고, Jeff Dean이 최근 발표한 슬라이드들에는 AutoML로 발견된 모델이 기존의 모델들보다 성능이 비슷하거나, 뛰어난 경우들이 많다고 소개하고 있다. 그러므로, 주어진 데이터셋을 잘 학습하는 모델들을 구하는것이 과거에 비해서 많이 용이해졌고, 전이학습등을 통해 기존 모델들을 다른 데이터셋에 이식시켜 사용할 수 있으니, 이제는 실제 적용하고 보편화 하는 단계가 이슈인 것이다. 이러한 최근의 트렌드를 가지고, 그럼 이 책이 독자들에게 어떤 이점들을 가져다 줄 수 있는지 살펴보자.
이 책의 구성에 대해서 살펴보면, 크게 3가지 파트로 나뉜다. 첫번째 파트는 기초에 대한 파트로, 바둑에 대한 룰과 머신러닝, 그리고 간단한 바둑 봇 실습이 있다. 아무래도 게임 AI를 다루다보니, 강화학습에 대한 내용이 주로 쓰이고 있다. 그렇기 때문에, 머신러닝에 대한 큰 틀이 아직 잡히지 않은 독자들은 챕터 1에 머신러닝 분류를 잘 읽어서 bird-eyed view를 먼저 가지고, 그것을 기반으로 이 책이 다루는 부분을 명확히 인지하는 것이 필요하다.
파트 2로 들어오면서 딥러닝을 위한 신경망의 기초와, 강화학습을 위한 트리 탐색, 그리고 이러한 지식들을 기반으로 어떻게 바둑을 위한 신경망을 설계하는지 다룬다. 이 책에 또 하나의 장점은, 이러한 기초설명 이후 실제 바둑 AI 구현을 위한 실습 설명이 매우 자세하다는 것이다. 지금까지 다양한 머신러닝 / 딥러닝 책을 읽었는데, 보통 머신러닝책은 확률과 통계를 기반으로 한 클래식한 머신러닝부터 최근의 신경망 기반의 딥러닝을 간단히 설명하고 마치거나, 딥러닝 책은 신경망에 대한 설명과, 유명한 딥러닝 모델들을 소개하는 방식이 많았다. 넓은 범위를 커버하는 반면에 디테일한 부분들이 많이 떨어져서, 읽고 나서 머신러닝 / 딥러닝을 잘 이해하게 되었다고 말하기 힘든 책들이 정말 많았다. 반면 이 책은, 범위를 좁혀서 바둑이라는 문제 해결을 위해, 딥러닝과 강화학습의 기반 지식들과 실제 개발 과정을 상세하게 적어둔 것이 강점이라고 생각한다. 다만, 범위를 좁히고 디테일한 설명을 하는 비용으로, 초심자용 책은 아니며 앞서 말한 머신러닝/딥러닝 책들을 읽고 나서 읽는 것을 추천한다.
마지막 파트 3은 파트 2의 연장선 상으로 바둑 AI를 더 강력하게 만들기 위한 기법들을 소개한다. 책의 내용이 꽤 많으므로, 딥러닝과 강화학습을 공부하고자 이 책을 이용하면 파트 2까지 우선적으로 읽는 것을 추천하며, 시간이 되거나 실제 프로젝트 적용을 위해서라면 파트 3도 읽으면 좋을 것 같다. 이 책은 매챕터마다 구현에 대한 설명이 자세히 나온다. 이게 장점이라면 장점이고, 단점이라면 단점인데, 그 이유는 책의 신선도가 금방 떨어질 수 있기 때문이다. 텐서플로우와 케라스가 2015년에 릴리즈되고, 통합되기까지 3년이 걸리지 않았다. 새로운 딥러닝 프레임워크들은 계속해서 나오고, 기존에 프레임워크들도 API가 바뀌거나, 새로운 기능 추가 및 기존 기능들이 사라지는 경우도 매우매우 잦다. 이 책의 구현 설명이 디테일 한 것은 그렇기 때문에 장점이 될 수도, 단점이 될 수도 있다. 물론, 책내용을 따라가면서 버전이슈들을 만날때마다 스스로 찾아내서 고칠수 있으면 크게 상관없다. 하지만 그런 작업은 영문으로 작성된 공식 도큐먼트나 영문 자료들을 찾아봐야할 경우가 많기 때문에, 실습할때 책에서 사용한 버전과 같은 버전을 사용하는 것을 추천한다. Max Pumperla는 예제 코드들을 github에 공유하고 있으니, 참고하면 책 내용 따라가는데에 도움이 많이 될 것이다 (https://github.com/maxpumperla/deep_learning_and_the_game_of_go).
리뷰를 정리하면, 책이 타게팅하는 분야가 넓지 않기 때문에 초보자용 입문서는 아니며, 이미 머신러닝/딥러닝/강화학습에 대한 레이아웃을 알고, 강화학습 & 딥러닝을 더 제대로 파보고 싶은 사람들이 타겟 독자층이다. 하지만, 시중에 나온 머신러닝/딥러닝 서적들은 대체적으로 넓은 분야를 전반적으로 설명하는 책들이 많기 때문에, 그런 책들을 처음 입문서로 보고 이 책을 읽는 것을 추천한다. 넓은 분야의 입문서들을 읽으면서 예제들을 많이 해보겠지만, 그 예제들을 통해 내가 진짜 머신러닝을 좀 제대로 파봤다고 느끼는 사람은 거의 없을 것이다. 그런 막연함을 덜어내고, 조금 더 구체화하고 싶다면 이 책을 읽는 것을 추천한다. 또한, 책에 설명이 디테일하여 좋긴 하지만, 머신러닝 프레임워크/라이브러들의 발전속도가 매우 빠르므로 책의 신선도가 떨어지기 전에 빨리 보는 것이 좋을 것이다. 너무 버전 이슈나 라이브러리 / 프레임워크의 엔지니어링 디테일에 시달려서 책에서 학습하고자 하는 내용을 놓치면 책을 읽는 이유가 없으므로, 실습할때 저자가 사용한 버전과 같은 버전을 사용하는 것을 추천한다.