독자리뷰
어려웠던 AI 속의 수학 개념을 친절히 알려주는 도서
sangj***
2026-03-02
"한빛미디어 서평단 <나는리뷰어다> 활동을 위해서 책을 협찬받아 작성된 서평입니다."
이 책을 덮고 나서 가장 먼저 든 생각은 이거였습니다.
“아, 내가 매일 쓰는 AI 서비스들이 이런 수학 위에 서 있었구나.”
솔직히 말하면 저는 수학을 잘하는 편이 아닙니다. 미분, 적분, 행렬이라는 말만 들어도 예전 시험지가 떠오르는 사람이에요. 그런데 이 책은 수학을 잘하는 사람을 위한 책이라기보다, 수학이 왜 필요한지 궁금한 사람을 위한 책에 가깝습니다. 특히 AI와 연결해 설명해주기 때문에, “이걸 왜 배우지?”라는 의문이 거의 들지 않았습니다. 이 책은 AI를 기능별로 나눠서 설명합니다. 검색, 추천, 이미지 분류, 문장 생성, 음성 분석, 위치 측정까지. 우리가 일상에서 접하는 기술을 하나씩 꺼내서, 그 안에 숨어 있는 수학을 보여줍니다.
정보 검색에 활용되는 수학 – 구글 검색창 뒤에 숨어 있는 계산들
첫 장은 검색입니다. 구글이나 네이버에서 뭔가를 검색하면, 수많은 문서 중에서 가장 “관련 있어 보이는” 결과를 위로 올려줍니다. 이때 쓰이는 것이 정밀도와 재현율입니다. 정밀도는 “보여준 것 중에 진짜 맞는 게 얼마나 되느냐”이고,
재현율은 “전체 정답 중에 얼마나 찾아냈느냐”입니다.
이 개념은 단순해 보이지만, AI 모델을 평가할 때 지금도 그대로 쓰입니다. 예를 들어 스팸 메일 필터, 의료 영상 판독, 이상 탐지 시스템 모두 이 지표로 성능을 평가합니다. 그리고 등장하는 것이 TF-IDF입니다. 어떤 단어가 한 문서 안에서 자주 등장하면 중요할 가능성이 높지만, 모든 문서에서 자주 등장하는 단어라면 오히려 중요하지 않을 수 있습니다. 이 균형을 잡기 위해 로그와 반비례 개념을 사용합니다.
이 부분을 읽으면서 “아, 벡터화라는 게 결국 문장을 숫자로 바꾸는 작업인데, 왜 숫자이어야 하는 지 알겠구나”라는 걸 생각하게 됐습니다. AI는 글을 읽는 게 아니라, 숫자를 계산하는 존재라는 걸요. 마지막에 RAG(검색 증강 생성)를 연결해 설명하는 부분은 특히 좋았습니다. 요즘 LLM이 왜 검색과 결합되는지, 그 뿌리가 여기 있다는 걸 보여줍니다.
상품 추천 – 넷플릭스와 쿠팡 뒤에 있는 행렬
이 장은 개인적으로 가장 재미있었습니다. 추천 시스템은 “비슷한 사람은 비슷한 취향을 가진다”는 가정에서 출발합니다.
이걸 수학적으로 표현하면 평가 행렬이 됩니다.
사용자 × 상품 표를 만들고, 빈칸을 채우는 문제로 바뀝니다.
여기서 등장하는 것이 행렬 인수 분해와 경사 하강법입니다.
책은 이렇게 설명합니다.
“우리는 오차를 줄이고 싶다.
오차를 줄이려면 어느 방향으로 움직여야 하는지 계산하면 된다.”
그게 바로 미분이고, 그 방향으로 조금씩 내려가는 것이 경사 하강법입니다. 이 개념은 추천 시스템뿐 아니라, 딥러닝 전체의 핵심입니다. AI는 결국 손실 함수를 정의하고, 그 값을 최소화하는 방향으로 움직이는 존재입니다.
세런디피티(우연한 발견)를 다룬 부분도 인상적이었습니다. 수학적으로 정확한 추천이 항상 사용자에게 좋은 경험을 주는 건 아니라는 점. AI 모델 설계에서 사람 중심 사고가 왜 중요한지도 생각하게 됩니다.
이미지 분류 – CNN과 오차 역전파
여기에서 CNN이 등장합니다. 합성곱, 풀링, 가중치, 편향 같은 용어가 나옵니다. 처음엔 어렵지만, 핵심은 이것입니다.
이미지는 숫자 격자(행렬)다.
CNN은 이 숫자 패턴을 반복적으로 변환하면서 특징을 추출하고, 마지막에는 소프트맥스 함수로 “이건 고양이일 확률 80%, 개일 확률 20%”처럼 확률로 바꿉니다.
오차 역전파 부분은 특히 좋았습니다. 앞에서 계산된 결과가 틀렸다면, 그 오차가 뒤로 전파되어 가중치를 수정한다는 개념. 이게 딥러닝의 학습 원리입니다.
이 장을 읽고 나니, AI 모델이 블랙박스처럼 보이던 느낌이 조금은 줄어들었습니다.
문장 생성 – 트랜스포머와 확률
AI의 중심은 누구나 알듯, 트랜스포머 아키텍처입니다. 이 장은 GPT 같은 모델이 어떻게 문장을 생성하는지 수학적으로 설명합니다.
핵심은 어텐션입니다.
단어 하나를 이해할 때, 다른 단어들과 얼마나 관련 있는지를 계산합니다.
이걸 행렬 곱으로 계산합니다.
처음에는 행렬 곱이 왜 이렇게 중요한지 몰랐는데, 이 장을 읽고 나서 이해했습니다. 트랜스포머는 결국 거대한 행렬 연산 기계입니다. 소프트맥스로 확률을 만들고, 그 확률을 기반으로 다음 단어를 선택하는 구조.
AI가 “생각”하는 게 아니라, 확률적으로 가장 그럴듯한 단어를 이어 붙인다는 걸 명확히 보여줍니다.
이 장은 LLM을 공부하는 사람이라면 반드시 읽어야 할 부분이라고 생각합니다.
음성 분석 – 푸리에 변환의 세계
늘...말로만 듣던 푸리에 함수..
이 장은 수학적으로 가장 어려웠지만, 동시에 가장 아름다웠습니다.
소리는 파동입니다. 복잡한 파동을 여러 개의 단순한 사인, 코사인 파형으로 나눌 수 있다는 게 푸리에 해석입니다.
이게 왜 AI와 관련 있냐면, 음성을 숫자로 변환해야 딥러닝 모델이 처리할 수 있기 때문입니다. 음성 인식 모델은 시간 영역 신호를 주파수 영역으로 변환한 뒤 학습합니다. 푸리에 급수, 오일러 공식, 직교성까지 이어지는 흐름은 솔직히 쉽지 않았지만, “수학적으로 생각한다는 것”이 무엇인지 보여주는 장이었습니다.
위치 측정 – GPS와 상대성 이론
마지막 장은 의외로 위치 측정입니다.
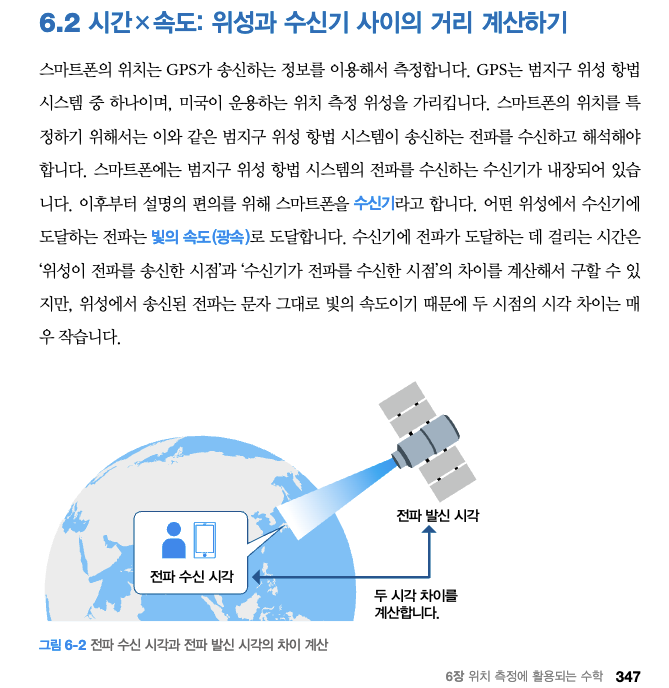
위성과 수신기 사이 거리 계산에서 시작해, 뉴턴 역학, 미분 방정식, 심지어 상대성 이론까지 갑니다.
왜 이게 AI 책에 들어가 있을까?
제 생각엔 이 책이 “AI를 움직이는 수학”을 보여주고 싶었기 때문입니다. GPS 오차 보정도 수학적 모델링이고, 그것 역시 데이터 기반 예측과 연결됩니다. 특히 상대성 이론으로 시간 지연을 보정하는 부분은, 우리가 쓰는 기술이 얼마나 정밀한 계산 위에 있는지 깨닫게 합니다.
이 책의 가장 큰 장점
수학을 공식이 아니라 이야기로 설명합니다.
AI와 연결해 설명하기 때문에 동기부여가 됩니다.
검색 → 추천 → 이미지 → 언어 → 음성 → 위치로 이어지는 구성 덕분에 AI의 전체 지도가 그려집니다.
이 책을 읽고 나니, AI는 마법뒤에 숨은 계산이라는 걸 이해하게 되었습니다.
그리고 그 계산의 언어가 바로 수학이라는 것도요.
수학을 잘 모르는 사람에게도 추천하고 싶은 이유는,
이 책이 “수학을 가르치려는 책”이 아니라 “AI를 이해시키기 위해 수학을 꺼내는 책”이기 때문입니다.
AI를 쓰는 사람에서, AI를 이해하는 사람으로 한 단계 올라가고 싶다면 이 책은 충분히 가치가 있습니다.


