독자리뷰
LLM의 기본적인 원리를 이해하고 실무에 적용하는데 도움되는 도서
sangj***
2025-11-30
실무로 통하는 LLM 애플리케이션 설계
아키텍처 설계부터 최적화까지 한 권으로 배우는 LLM 애플리케이션 개발 전략
- 저자 : 수하스 파이
- 번역 : 박조은
- 출간 : 2025-10-16
최근에 LLM 관련 책을 여러 권 읽어봤지만, 이 책처럼 “실제로 만들고 운영해본 사람이 쓴 느낌”을 주는 책은 거의 없었다. 이론을 나열하는 책이 아니라, 실무에서 진짜로 부딪히는 문제들을 어떻게 풀어야 하는지를 중심으로 설명한다는 점이 가장 큰 장점이었다.
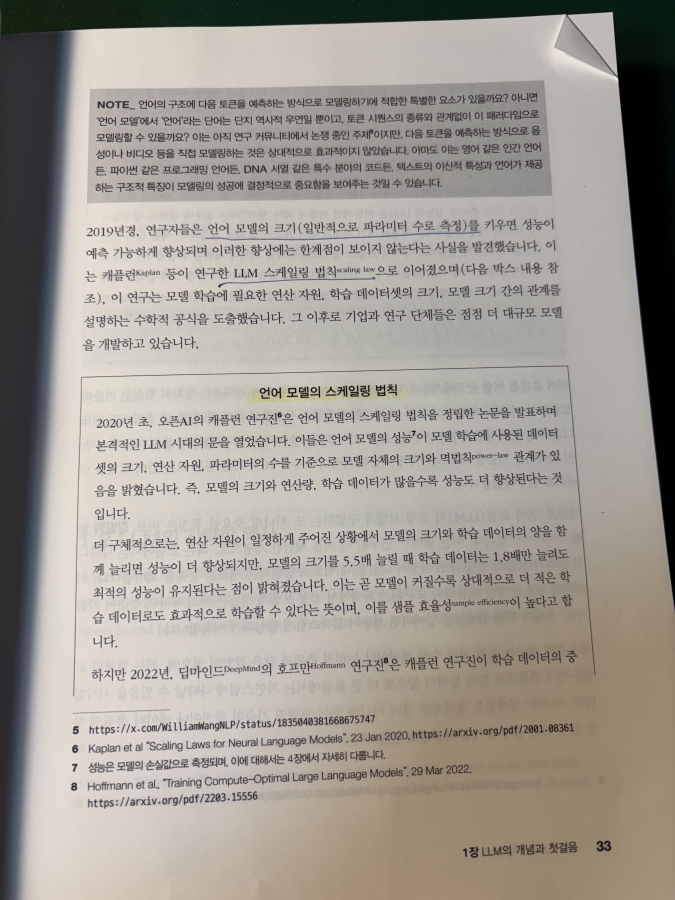
책의 초반부에서 LLM 스케일링 법칙을 다시 정리해주는 부분이 마음에 들었다. 모델의 성능은 단순히 파라미터 수로 결정되는 게 아니라 데이터량, 연산량, 모델 크기 사이의 균형이 중요하다는 내용을 강조하는데 실제로 실무에서 “모델 더 키우면 성능 좋아지나요?” 같은 얘기를 들을 때 늘 설명하기 어려웠던 지점을 명확하게 짚어준다. 손으로 적어둔 스케치처럼 프롬프트가 입력되고 모델이 출력을 만들고 다시 그 결과가 컨텍스트로 쌓이는 흐름을 시각적으로 풀어준 점도 좋았다. 이 구조는 이후 RAG나 에이전트 파트를 이해할 때 기초로 계속 쓰이기 때문에 초반에 확실하게 잡아주는 게 꽤 도움이 됐다.
데이터 챕터에서는 합성 데이터의 장단점을 정리한 내용이 실무 감각 그대로라서 공감이 많이 갔다. 요즘 synthetic data를 활용하는 사례가 많지만, 이 책처럼 합성이 정렬이나 규칙 기반 작업에는 도움이 되는 반면 실제 지식형 태스크에서는 한계가 있다는 설명을 깔끔하게 정리해주는 책은 많지 않다. 토큰화 챕터도 생각보다 유익했는데, 단순히 단어를 조각내는 기술 정도로만 알고 있던 토크나이저가 모델의 속도, 비용, 컨텍스트 길이까지 사실상 모든 구조를 결정하는 ‘초기 설계 요소’라는 점을 실용적인 시선으로 설명해준다.
트랜스포머 구조를 하나의 흐름도로 정리한 그림은 이 책 전체에서 손에 꼽을 만큼 잘 만든 구성이다. 입력에서 시작해서 임베딩과 위치 인코딩을 거쳐 멀티헤드 어텐션, 피드포워드, 정규화, 소프트맥스까지 이어지는 전체 플로우가 딱 한 페이지에 정리되어 있으니, 이걸 기준으로 모델 내부 구조가 한 번에 정리되는 느낌이었다. 이후에 등장하는 KV 캐싱이나 디코딩 최적화 같은 개념들이 훨씬 더 쉽게 연결되기도 했다.
LLM을 어떻게 선택하고 활용할지에 대한 실전 조언들도 꽤 현실적이다. 대부분 모델을 비교할 때 정확도나 파라미터 수만 보는데, 실제로 사용자 체감 품질은 TPT, 즉 초당 생성되는 토큰 속도에서 갈린다는 점을 강조하는 부분이 특히 좋았다. 내가 GPU 인스턴스에서 다양한 LLM을 튜닝할 때 결국 서비스 품질을 좌우하는 건 “얼마나 빨리 답이 오느냐”였기 때문에, 이 챕터 내용은 실무 경험과 정확히 맞아떨어졌다.
파인튜닝 부분도 중급자에게 도움이 되는 구성이었다. 요즘은 완전 파인튜닝보다 PEFT나 RAG 조합으로 해결하는 게 일반적이라는 현실적인 조언이 좋았고, 이어지는 고급 파인튜닝에서는 LoRA나 QLoRA를 단순히 소개하는 것이 아니라 어떤 레이어에 어떤 방식으로 적용하느냐가 더 중요하다는 내용을 짚어줘서 실전적인 깊이가 있었다.
환각 파트는 이 책에서 유독 돋보인다. 환각을 단일 문제로 취급하는 것이 아니라 인컨텍스트 환각, 오정보 기반 환각, 데이터 부족형 환각 등 여러 유형으로 분류해 다루는데, 이런 정리가 잘 된 자료는 실제로도 흔치 않다. LLM 환각을 해결하려고 할 때 원인이 무엇이냐에 따라 해결책이 달라진다는 점을 자연스럽게 이해하게 해준다.
그리고 개인적으로 이 책의 백미는 추론 최적화 챕터였다. 효율적인 추론을 위해 고려해야 할 것이 연산량을 줄이는 것, 디코딩 속도를 높이는 것, 저장 공간을 절약하는 것이라는 문장이 있는데, 실제로 GPU 최적화 회의에서 엔지니어들이 사용하는 표현과 거의 완전히 동일하다. KV 캐싱, 양자화, 프루닝, 메모리 접근 최적화 같은 기술을 ‘왜 써야 하는지’부터 ‘실제로 어떤 상황에서 효과가 있는지’까지 연결해서 설명해 주는 챕터라 바로 실무에 가져다 쓸 수 있을 것 같았다.
에이전트 개념을 설명하는 방식도 좋았다. 에이전트가 목표를 위해 스스로 작업 순서를 정하고, 필요하면 API나 DB, 코드까지 직접 호출하는 시스템이라는 정의는 요즘 과하게 추상화된 ‘에이전트’ 마케팅 문구들을 일거에 정리해 준다. 이미지에서 적어둔 메모처럼 “우선순위 결정 → 작업 순서 구성 → 도구 호출”이라는 흐름이 에이전트의 본질이라는 설명이 특히 와닿았다.
임베딩 챕터에서는 768차원 임베딩 값을 직접 출력해 보여주는 예제가 직관적이었다. 임베딩이라는 개념을 추상적인 벡터로만 설명하지 않고 실제 값과 함께 설명해주니, 임베딩 크기 최적화나 의미 검색, 유사도 측정 방식 같은 뒤쪽 내용도 훨씬 명료하게 바라볼 수 있었다.
RAG 관련 파트도 기대 이상이다. 대부분의 책은 RAG를 검색 + 생성 구조 정도로만 설명하지만 이 책은 RAG를 메모리 관리, 컨텍스트 선정, 모델 훈련 보조, 파인튜닝 대안, 긴 컨텍스트의 경쟁 구조 등 훨씬 넓은 관점에서 다룬다. 요즘 RAG가 사실상 LLM 시스템의 중심이 되는 걸 생각하면, 이 수준의 정리는 실무에서 바로 활용 가능한 깊이다.
마지막으로 시스템 아키텍처 챕터에서는 단일 LLM이 아니라 여러 모델과 도구, 에이전트, 파이프라인을 조합해서 완성되는 멀티 LLM 구조를 어떻게 설계해야 하는지 설명하는데, 최근 기업들이 AI 시스템을 구축할 때 실제로 고민하는 문제들과 거의 정확히 맞아떨어진다.
전체적으로 이 책은 LLM을 “사용해본 단계”에서 “제대로 설계하고 최적화하고 제품화할 수 있는 단계”로 가고 싶은 사람에게 딱 맞는 책이다. 실무에서 마주치는 문제들을 구체적인 언어로 설명해 주기 때문에, 나처럼 이미 LLM을 다뤄본 사람도 충분히 배울 게 많았다. LLM 기반 서비스를 직접 만들고 운영할 계획이 있다면 한 번쯤 읽어볼 가치가 충분하다.


