독자리뷰
지금 바로 읽어야 할 자연어 처리 필독서
dhan***
2025-07-27

핸즈온 LLM
LLM, 눈으로 익히고 손으로 구현하라. 트랜스포머 구조부터 시맨틱 검색, 미세 튜닝, 프롬프트 엔지니어링까지 그림과 실전 코드로 만들면서 배우는 대규모 언어 모델의 모든 것
- 저자 : 제이 알아마르 , 마르턴 흐루턴도르스트
- 번역 : 박해선
- 출간 : 2025-06-02
최근 개발되는 대부분의 서비스가 생성형 AI(LLM)를 사용할 정도로 그 열기가 대단하다. 사실 우리가 제대로 인식하지 못했지만, 자연어 처리 분야의 인공지능 기술은 텍스트 분류, 클러스터링, 개체명 인식, 기계 번역 분야에서 이미 사용되고 있었다. 최근 ChatGPT, Claude, Gemini, Grok등의 프런티어 모델은 다방면에서 우수한 성능을 보여준다. 하지만 보안과 가격 정책으로 제품화에 적합하지 않거나, 개발하려는 도메인과 맞지 않는 경우가 여전히 많다. 때로는 배보다 배꼽이 더 큰 경우도 있다. 따라서, 우리는 LLM의 개념을 제대로 이해하여 개발하려는 도메인에 가장 적합한 모델을 찾고 개선하여 제품화하는 능력을 키울 필요가 있다.
[선수 지식]
- 파이썬과 머신러닝(텐서플로, 허깅페이스, 케라스) 기초
- 자연어 처리 기초(토크나이저, 임베딩, 텍스트 분류, 클러스터링, 토픽 모델링, 검색, 차원 축소)
- LLM 서비스, API 사용 경험
[추천 독자]
- 생성형 AI를 활용한 자연어 처리를 배우려는 개발자
- 생성형 AI를 활용하여 제품을 만들고 싶은 개발자
- 오픈 모델을 사용하여 서비스를 개발하고 싶은 개발자
- 오픈 모델 미세 튜닝을 통해 모델의 성능을 높이고 싶은 개발자
[키워드]
#LLM #트랜스포머 #인코더 #디코더 #자연어처리 #토큰 #임베딩 #추천시스템 #분류 #지도학습 #BERT #T5 #ChatGPT #클러스터링 #토픽모델링 #프롬프트엔지니어링 #체인 #메모리 #에이전트 #시맨틱검색 #RAG #리랭킹 #멀티모달 #비전트랜스포머 #대조학습 #SBERT #미세튜닝 #비지도학습 #지도분류 #퓨샷분류 #개체명인식 #LoRA #QLoRA #벤치마크 #선호도튜닝 #정렬 #RLHF #DPO #양자화 #SFT #PEFT
[특징]
- 어려운 개념을 그림을 통해 알기 쉽게 설명 (거의 그림책 수준)
- 주요 논문 내용을 인용하여 개념을 자세히 설명
- 허깅페이스의 오픈 모델과 코랩을 사용한 실습
- 실전에서 바로 사용할 수 있는 수준의 실습 코드
- 임베딩 모델과 생성형 AI 모델의 훈련 방법 및 미세 튜닝 방법 제공
- 옮긴이의 친절한 부연 설명
[책의 구성]
이 책은 전체 3부, 12개 장으로 구성되어 있다.
1부 "언어 모델 이해하기"는 3개의 장으로 인공 지능 분야에서 자연어 처리 모델의 역사와 개념 및 용어를 설명한다.
1장 "대규모 언어 모델 소개"에서는 인공 지능에서 자연어 처리 분야의 역사와 개념을 그림과 함께 상세히 설명한다.
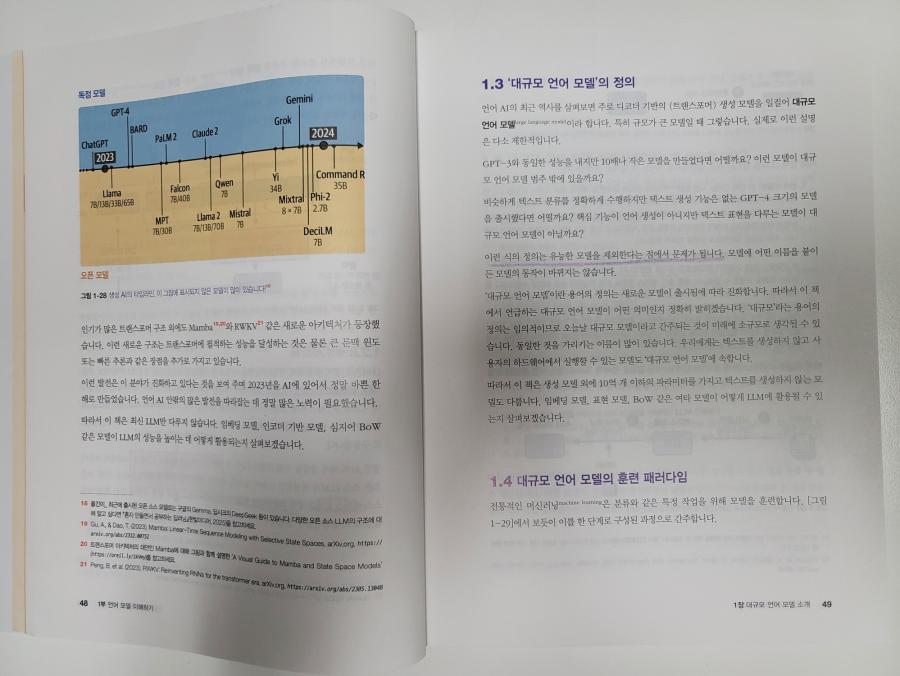
<1부 언어 모델 이해하기 - 1장 대규모 언어 모델 소개, p48~p49>
2장 "토큰과 임베딩"에서는 자연어 처리의 핵심인 토크나이징과 임베딩의 개념을 설명하고, 임베딩의 종류별 결과를 보여주고, word2vec 모델로 실습한다.
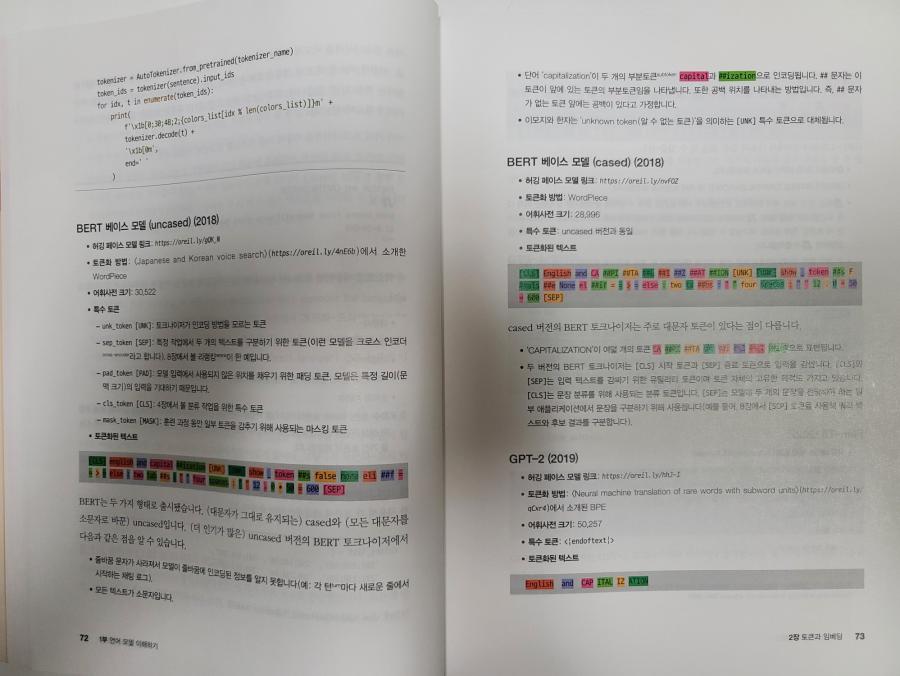
<1부 언어 모델 이해하기 - 2장 토큰과 임베딩, p72~p73>
3장 "대규모 언어 모델 자세히 살펴보기"에서는 트랜스포머 모델의 개념을 설명하고, 코드를 통해 개념을 구체화하여 설명한다.
2부 "사전 훈련된 언어 모델 사용하기"는 6개 장으로 허깅페이스의 자연어 처리 모델을 사용하여 다양한 상황에서의 활용법을 설명한다.
4장 "텍스트 분류"에서는 텍스트 분류 개념을 설명한 후 BERT, T5, ChatGPT로 텍스트를 분류하는 방법을 설명한다.
5장 "텍스트 클러스터링과 토픽 모델링"에서는 파이프라인을 통해 텍스트 클러스터링의 개념을 설명하고, 토픽 모델링을 실습한다.
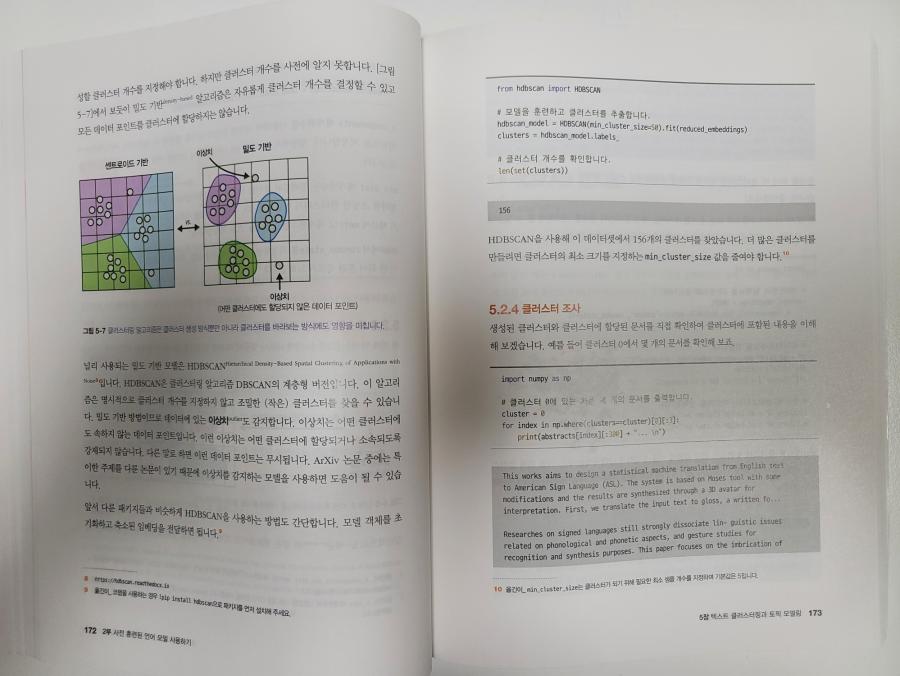
<2부 사전 훈련된 언어 모델 사용하기 - 5장 텍스트 클러스터링과 토픽 모델링 , p172~p173>
6장 "프롬프트 엔지니어링"에서는 프롬프트 엔지니어링의 개념과 구성 요소, 다양한 기법(제로샷, 퓨샷, CoT, ToT)을 예시와 함께 설명한다.
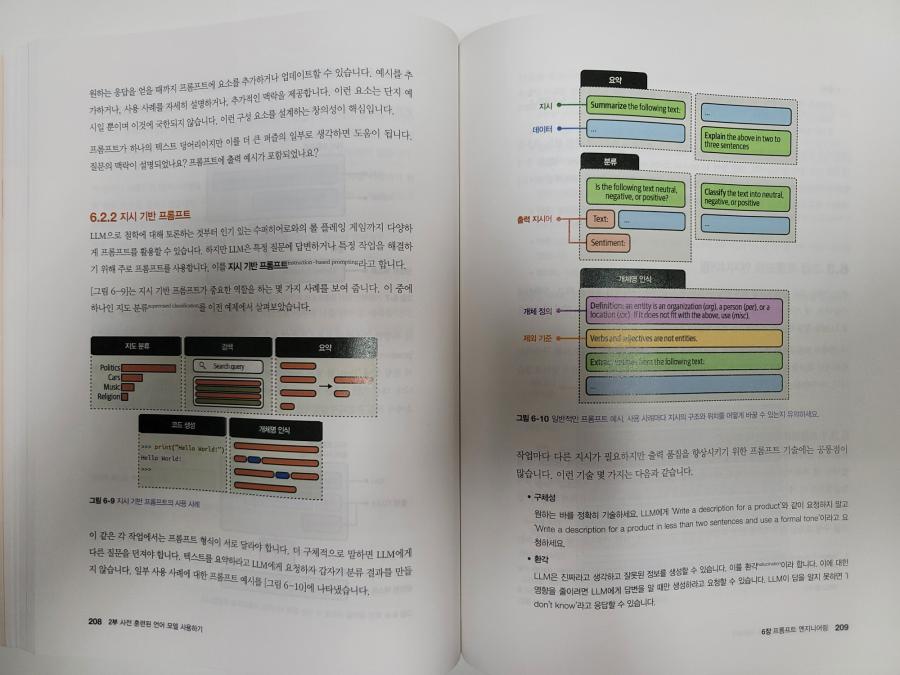
<2부 사전 훈련된 언어 모델 사용하기 - 6장 프롬프트 엔지니어링, p208~p209>
7장 "고급 텍스트 생성 기술과 도구"에서는 체인 기법, 메모리, 에이전트, ReAct를 예시를 들어 설명한다.
8장 "시맨틱 검색과 RAG"에서는 리랭킹을 활용한 검색의 개념을 설명하고, 로컬 모델과 FAISS를 사용한 RAG를 실습한다.
9장 "멀티모달 대규모 언어 모델"에서는 비전 트랜스포머의 개념과 텍스트 모델을 멀티모달 모델로 만드는 개념을 설명하고, 허깅페이스의 비전 모델사용하여 멀티 모달 실습을 진행한다.
3부 "언어 모델 훈련 및 미세 튜닝"는 3개의 장으로 자연어 처리 모델의 훈련 방법과 미세 튜닝 방법을 설명한다.
10장 "텍스트 임베딩 모델 만들기"에서는 대조학습을 통한 텍스트 임베딩 모델을 만드는 과정, 즉 데이터 생성, 훈련, 평가 방법과 비지도 학습으로 만드는 방법을 설명한다.
11장 "분류용 표현 모델 미세 튜닝하기"에서는 사전 훈련된 모델을 미세 튜닝하여 분류용 모델을 만드는 방법과 개선 방법을 설명한다.
12장 "생성 모델 미세 튜닝하기"에서는 생성형 AI 모델을 훈련하는 방법, 정렬(Alignment)하는 방법과 LoRA를 사용한 미세 튜닝 방법, SFT, RLHF, DPO 기법을 사용한 선호도 미세 튜닝 방법을 설명한다.
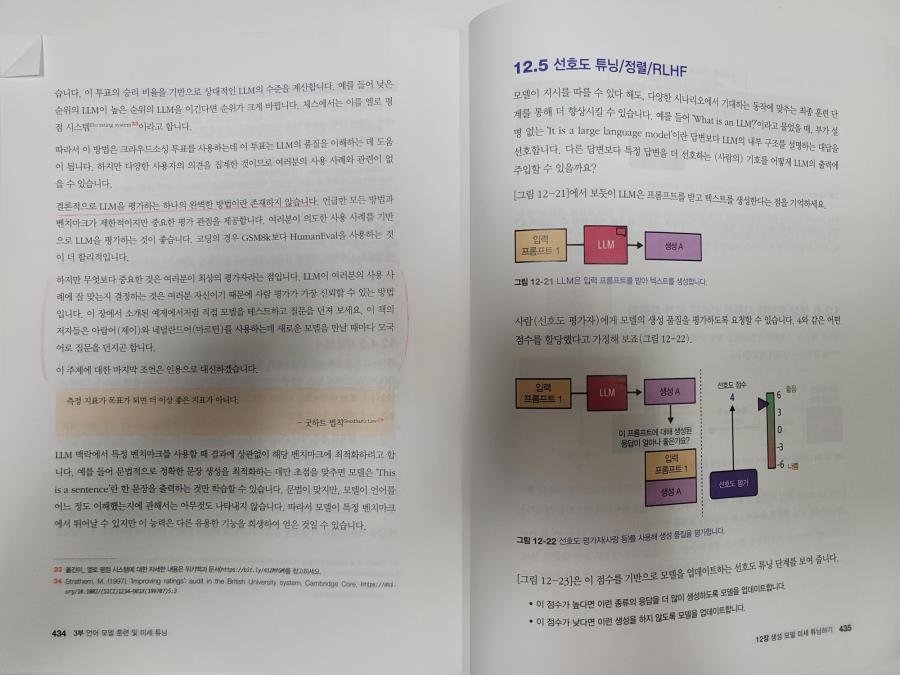
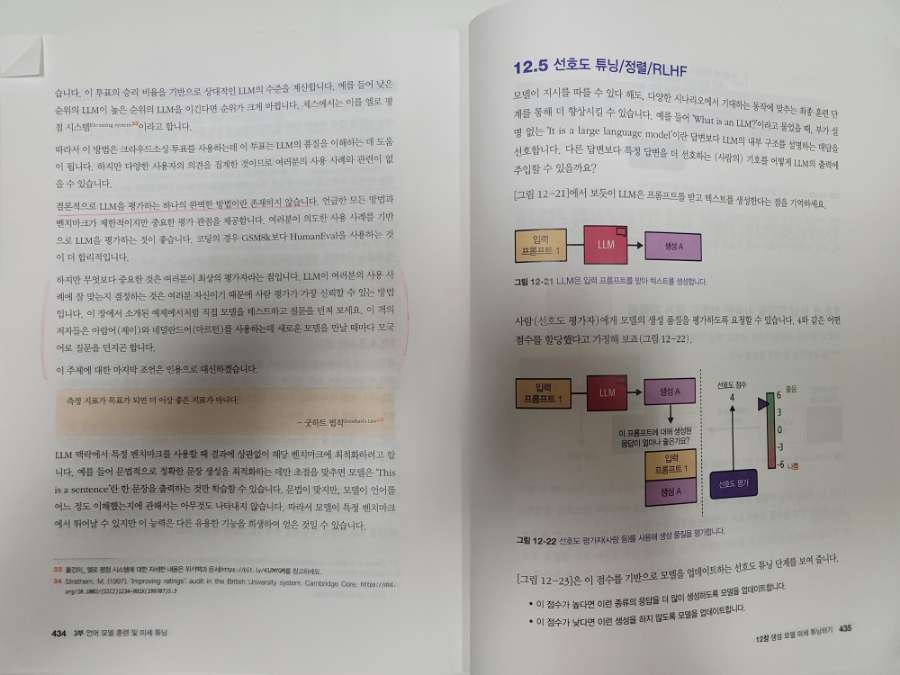
<3부 언어 모델 훈련 및 미세 튜닝 - 12장 생성 모델 미세 튜닝하기, p434~p444>
[인용]
LLM의 다양한 평가 방법(벤치마크)에서 사람 평가의 중요성을 강조한 부분이 인상적이다. 우리의 목표는 좋은 점수가 아니라 좋은 서비스이기 때문이다.
결론적으로 LLM을 평가하는 하나의 완벽한 방법이란 존재하지 않습니다.
<중략>
하지만 무엇보다 중요한 것은 여러분이 최상의 평가자라는 점입니다. LLM이 여러분의 사용 사례에 잘 맞는지 결정하는 것은 여러분 자신이기 때문에 사람 평가가 가장 신뢰할 수 있는 방법입니다.
<중략>
직접 모델을 테스트 하고 질문을 던져 보세요.
측정 지표가 목표가 되면 더 이상 좋은 지표가 아니다 - 굿하트 법칙
12장 생성 모델 미세 튜닝하기, p434
[소감]
이 책을 읽으면서 왜 아마존 AI 분야의 베스트셀러이면서 컴퓨터 과학 분야의 베스트셀러인지 확실히 알게 되었다. 자연어 처리 개념과 실습이라는 두 마리 토끼를 모두 제대로 잡았다. 책에서 설명하는 개념은 기초부터 고급 응용까지 필요한 모든 부분을 다루고 있으며, 수식이 아닌 그림으로 개념을 단계적으로 알기 쉽게 설명하여 마지막까지 재미있게 읽을 수 있었다. 관련 기술의 논문도 자세히 설명한다. 기술서, 특히 핸즈온 책에서 이렇게 많은 그림이 있는 책은 처음 경험했다.
개인적으로는 12장의 생성 모델 학습 방법이 가장 인상 깊었다. 이런 개념을 다루는 책도 많지 않았지만, 양자화, LoRA, QLoRA, 평가 방법, 선호도 튜닝, 정렬(Alignment), RLHF, SFT, PEFT, DPO에 대한 개념을 확실히 이해할 수 있었다.
코드 실습 중에 오류가 나거나 라이브러리 설명이 부족한 경우, 옮긴이의 친절한 설명이 큰 도움이 되었다. 아쉬운 부분은 그림의 텍스트와 실습 코드가 모두 영어라는 점이다. 다행히 한글 모델을 찾고 한글로 적용하는 방법을 혼자 해볼 수 있는 과제가 있어서 좋았다.
[추천]
저처럼 자연어 처리에 대한 이해가 부족했거나 자연어 처리에 입문하시는 분, 미세 튜닝의 원리부터 고급 응용까지 배워보고 싶은 분들에게 이 책을 자신 있게 추천한다. 특히 폐쇄망에 지능형 정보서비스를 도입하고자 하시는 분들은 책의 실용적인 실습 코드가 큰 도움이 될 것이다.


