독자리뷰
웹 크롤러 분야 도서의 SOTA
dhan***
2025-03-28

"한빛미디어 서평단 <나는리뷰어다> 활동을 위해서 책을 협찬 받아 작성된 서평입니다."
웹 크롤러와 관련된 여러 책과 데이터 분석 책의 초반에 나오는 스크레이핑 부분을 통틀어도 이 책은 웹 크롤러 분야의 압권이라고 생각한다.
검색엔진 솔루션 업계에 근무하면서 수많은 사이트를 수집하였다. 고객의 요구 사항을 충족시키기 위해서 검색 결과 페이지(SERP), 사이트의 게시판 검색 결과 페이지, 특정 사이트 전체, 사이트의 특정(게시판) 게시글 전체, RSS(Really Simple Syndication), OPENAPI 등을 수집하였다. 수집한 이후에는 전처리를 진행한 후 결과 데이터를 파일이나 DB에 저장하고, 모니터링과 유지관리를 진행한다. 그동안 회사의 IP가 차단되기도 하고 일부 사이트는 원인을 모르고 수집이 안 되는 경우도 있었다. 이 모든 일련의 과정을 이 책에서는 한 눈에 알아보기 쉽게 정리하였고 풀리지 않는 문제에 관해 명쾌한 해답을 알려 준다. 내가 작업한 프로그래밍 언어는 파이썬이 아니었지만 굉장히 재미있게 읽었고, 책을 읽는 동안 파이썬이라는 언어는 전혀 문제가 되지 않았다.
생각해 보면 웹 크롤러는 프로그램의 종합 예술과도 같다. HTML, CSS, JAVASCRIPT는 당연히 알아야 하며, 네트워킹과 수집 대상의 인프라도 고려해야 한다. 데이터베이스와 모니터링을 할 수 있는 관리자 프로그램, 웹 기술이 발전함에 따른 AI OCR 기술, 정규표현식, LLM을 활용한 데이터 전처리도 고려할 수 있다. 이 모든 내용이 이 한권에 있다는 것이 정말 놀랍다.
추천 독자
웹 스크레이핑 입문자부터 실무자(파이썬과 상관없이)
안전하고 견고한 웹 크롤러 프로그램을 개발하고 싶은 프로그래머
데이터 분석을 위해 데이터 수집이 필요하신 분
키워드
#웹스크레이퍼 #웹스크레이핑 #스크래핑 #웹크롤러 #웹크롤링 #크롤링 #크롤러 #봇 #스파이더 #robots #스크레이피 #NLTK #테서랙트 #멀티쓰레딩 #CAPTCHA #이미지처리 #텍스트인식 #BeautifulSoup #정규표현식 #셀레니움 #단위테스트 #파이썬 #프록시 #인증 #스크랩 #Scraping
특징
프로그래밍, 특히 파이썬을 몰라도 전체적으로 내용이 쉽게 구성되어 있다. 파이썬 코드도 어렵지 않다.
웹스크레이핑의 역사와 작동원리, 활용 방안, 웹 크롤러 모델 설계, 실습 코드까지 한 권에 담고 있다.
웹 스크레이핑 실습 코드는 실무에 바로 사용해도 될 만큼 커버리지와 완성도가 높다.
평소에 궁금했던 웹 스크레이핑의 저작권, 합법성과 윤리적인 내용을 포함하고 있다.
제가 평소에 좋아하는 책 속에 책소개가 많이 포함되어 있다.
책의 구성
이 책은 2개 PART, 20개 장으로 구성되어 있다. 1부에서는 웹 스크레이퍼의 개념과 개발 시 고려해야 될 내용, 일반적인 웹 크롤러에 관해 설명하며, 2부에서는 수집이 까다로운 다양한 주제를 가지고 심층적으로 접근한다.
PART 1 웹 스크레이퍼 제작
CHAPTER 1 인터넷 작동 원리 - 여기서도 보게 되는 네트워크 OSI 모델과 HTML, CSS, JAVASCRIPT, 웹 브라우저 개발자 도구의 개념을 설명한다.
CHAPTER 2 웹 스크레이핑의 합법성과 윤리 - 저작권 문제와 침해와 관련된 사례 연구, robots.txt의 개념을 설명한다.
CHAPTER 3 웹 스크레이핑 활용 분야 - 이커머스(마케팅), 학술 연구, 제품 개발, 여행, 영업 등의 다양한 활용 분야를 설명한다.
CHAPTER 4 첫 번째 웹 스크레이퍼 - 주피터 노트북에서 BeautifulSoup를 사용하여 웹페이지를 수집해 본다.
CHAPTER 5 고급 HTML 분석 - 내가 원하는 사이트를 수집하기 위한 BeautifulSoup을 다양한 기능을 설명한다.
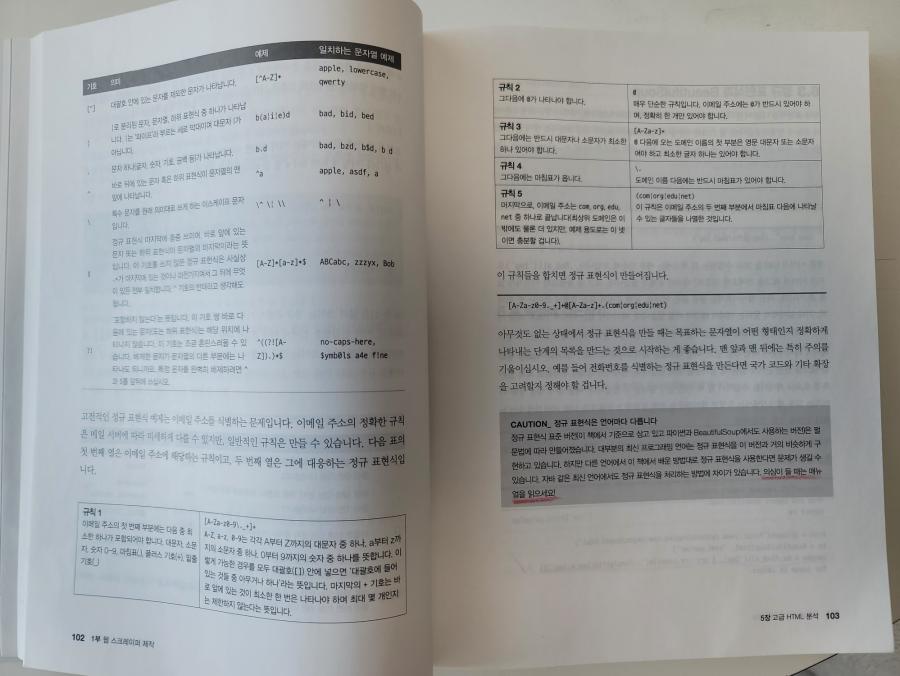
<1부 웹 스크레이퍼 제작, 5장 고급 HTML 분석, p102~p103>
CHAPTER 6 크롤링 시작하기 - 전체 사이트를 수집할 수 있는 방법을 설명한다.
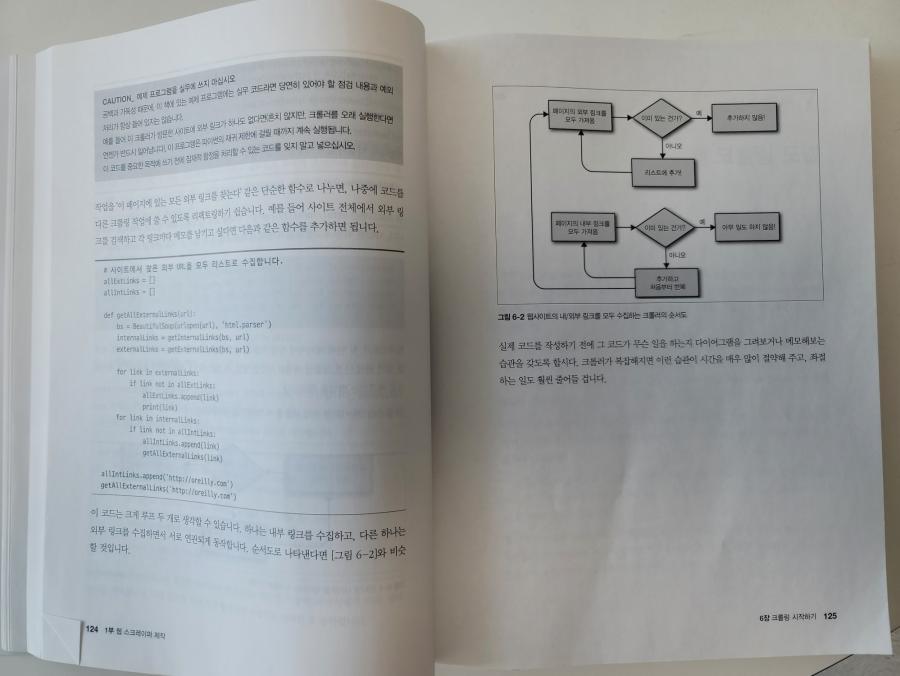
<1부 웹 스크레이퍼 제작, 6장 크롤링 시작하기, p122~p123>
CHAPTER 7 웹 크롤링 모델 -수집 대상에 따른 웹 크롤링 모델 패턴을 설명한다.
CHAPTER 8 스크레이퍼 - 스크레이피 프로그램을 사용하여 웹 스크레이퍼를 만든다.
CHAPTER 9 데이터 저장 - 수집한 결과를 저장하기 위해 파일, 데이터베이스, 이메일 전송 코드를 설명한다.
PART 2 고급 스크레이핑
CHAPTER 10 문서 읽기 - 인코딩된 텍스트 파일, CSV, PDF, MS 오피스 문서 읽는 방법을 설명한다.
CHAPTER 11 지저분한 데이터 다루기 - 기본적인 전처리 방법과 판다스 패키지를 활용한 전처리 방법을 설명한다.
CHAPTER 12 자연어 읽고 쓰기 - 수집한 문서에서 유의미한 통계적인 분석 결과를 도출하는 방법을 설명한다.(NLTK)
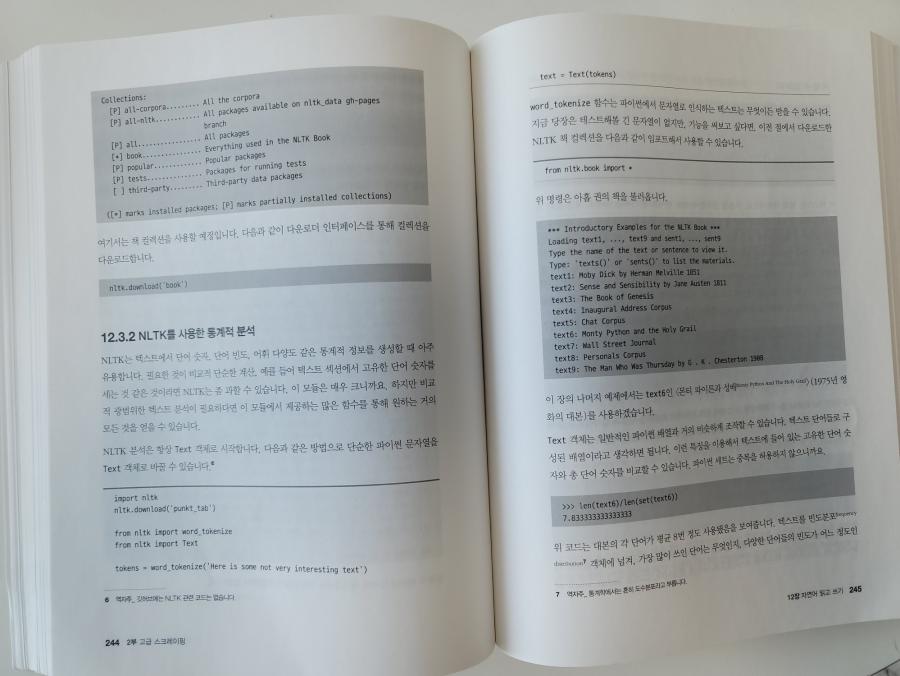
<2부 고급 스크레이핑, 12장 자연어 읽고 쓰기, p244~p245>
CHAPTER 13 폼과 로그인 뚫기 - 인증이 필요한 사이트를 수집할 수 있는 방법을 설명한다.
CHAPTER 14 자바스크립트 스크레이핑 - 자바스크립트로 동작하는 동적인 웹페이지를 수집하는 방법을 설명한다. (셀레니움)
CHAPTER 15 API를 통한 크롤링 - API의 개념과 인터넷에서 제공하는 오픈API를 활용하는 방법을 설명한다.
CHAPTER 16 이미지 처리와 텍스트 인식 - CAPTCHA(Completely Automated Public Turing test to tell Computers and Humans Apart)를 인식하는 방법을 설명한다.
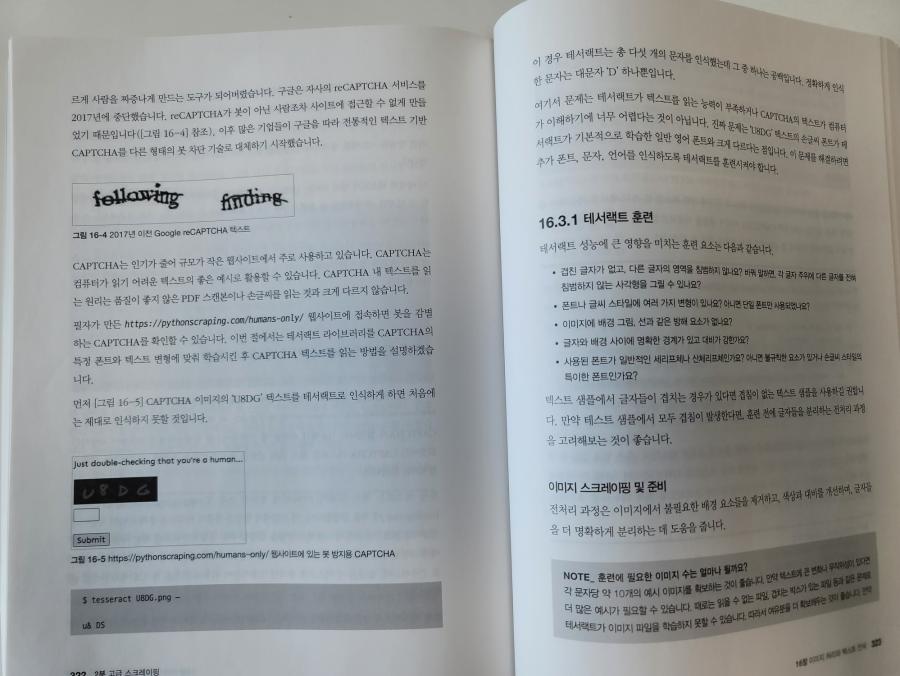
<2부 고급 스크레이핑, 16장 이미지 처리와 텍스트 인식, p322~p323>
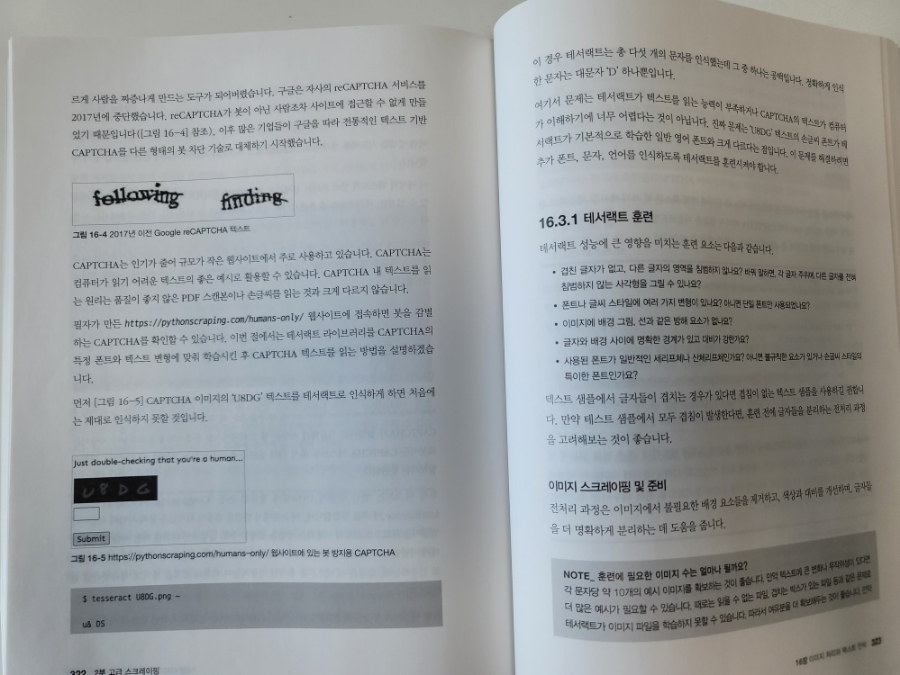
CHAPTER 17 스크레이핑 함정 피하기 - 스크레이핑을 막는 프로그램을 회피하는 방법을 알아본다.
CHAPTER 18 스크레이퍼로 웹사이트 테스트하기 - pytest와 셀레니움으로 운영 중인 웹페이지를 테스트하는 방법을 살펴본다.
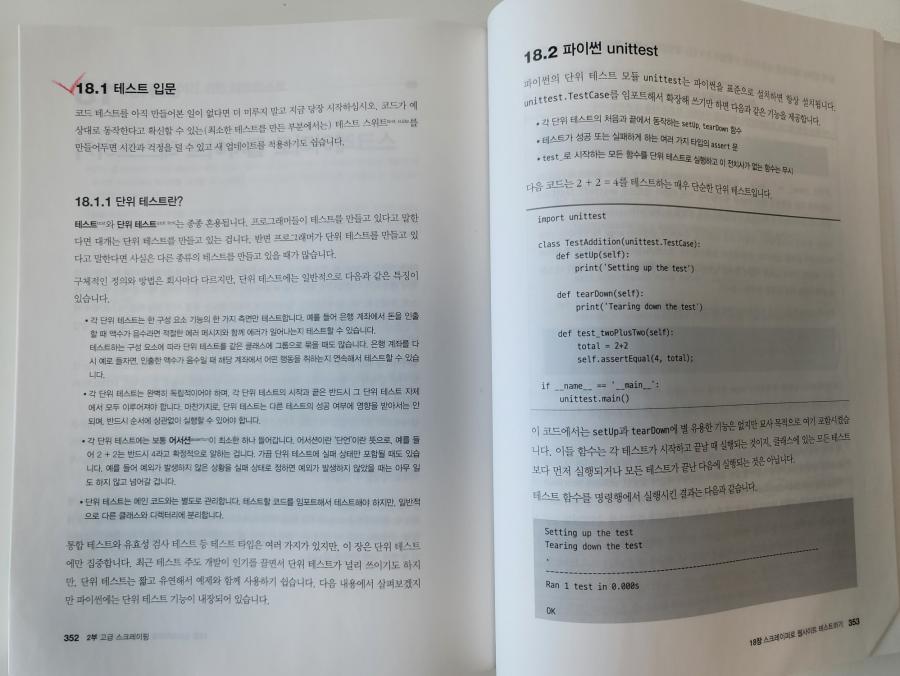
<2부 고급 스크레이핑, 18장 스크레이퍼로 웹사이트 테스트하기, p352~p353>
CHAPTER 19 병렬 웹 스크레이핑 - 멀티 쓰레딩, 멀티 프로세싱으로 처리하는 기법을 설명한다.
CHAPTER 20 웹 스크레이핑 프록시 - IP 주소 차단을 위한 우회 프로그램과 원격 호스팅, 프록시 제품의 장단점을 설명한다.
인용
웹 스크레이핑 프로젝트에 임할 때는 항상 스스로에게 다음과 같은 질문을 던져야 합니다.
- 지금 내가 처한 문제는 무엇인가?
- 어떤 데이터가 문제 해결에 도움이 되고, 어디에서 그걸 찾을 수 있나?
- 웹사이트는 이 데이터를 어떻게 표시하나/ 웹사이트의 코드 어느 부분에 이 정보가 들어있는지 정확히 파악할 수 있나?
- 데이터를 어떻게 정확히 찾아서 가져올 수 있을까?
- 데이터를 유용하게 만들려면 어떻게 처리하고 분석해야 할까?
- 이 방식을 더 좋게, 더 빠르게, 더 견고하게 개선하려면 어떻게 해야 할까?
<20장 웹 스크레이핑 프록시, p393>
소감
웹 스크레이핑을 하고자 계획하거나 웹 크롤러에 관심이 있으신 분은 꼭 읽어보길 추천 한다. 기존의 웹 크롤러를 개발하셨던 분들도 최신 기술을 포함하여 무지의 무지(Unknown unknown), 즉 어떤 문제나 정보에 대해 모르고 있다는 사실조차 모르는 상태를 벗어나도록 이 책이 도움을 줄 것이다. 저자의 경험은 단순한 데이터 수집 차원이 아니라 수집을 왜 해야 하며, 어떻게 해야 하고, 활용은 어떻게 하며, 앞으로 무엇을 해야 하는지에 관해 구체적인 해답을 알려준다.


