독자리뷰
우리 회사의 머신러닝 모델을 강하게 안전하게
ksh***
2024-06-23

머신러닝 리스크 관리 with 파이썬
책임감 있고 지속 가능한 ML 시스템을 배포하는 방법, AI 모범 사례와 위험 관리 프로세스 제대로 알고 활용하기
- 저자 : 패트릭 홀 , 제임스 커티스 , 파룰 판데이
- 번역 : 윤덕상 , 이상만 , 김경환 , 김광훈 , 장기식
- 출간 : 2024-05-10
한빛미디어 <나는 리뷰어다> 활동을 위해서 책을 제공받아 작성된 서평입니다.
패트릭 홀, 제임스 커티스, 파룰 판데이 지음 / 윤덕상, 이상만, 김경환, 김광훈, 장기식 옮김
최근 2024년 3월 8일, 유럽연합 의회에서 인공지능 기술을 안전하고 윤리적으로 사용할 수 있도록 하는 규제법안인 인공지능법을 승인했습니다. 대표적으로 자율주행의 경우에는 자칫 잘못된 결정을 한 경우에 사람의 생명까지 위협할 만큼 위험합니다. 또한 생명을 다루는 의료 분야(진단, 신약개발 등)에서도 활발히 인공지능을 개발되고 있습니다. 이처럼, 우리 삶 속에서의 인공지능이 미칠 수 있는 영역은 확대되고 있습니다. 확대가 됨에 따라, 올바르고 안전하게 사용할 수 있도록 다양한 규제 등이 강화될 것으로 보입니다. 모델을 만들고 활용하는 입장에서 어떻게 올바르게 리스크 관리를 할 것인가에 대한 내용을 다룬 책입니다.
1. 대상 독자 및 설명
이 책은 현업에서 머신러닝, 딥러닝을 활용하여 모델을 만드시는 분에게 도움이 될 수 있을 것 같습니다. 당연하게도 큰 기업에서는 이 책에서 말하는 문제 등에 대해 이미 대비가 되어 있는 경우가 많을 것 같습니다만 저처럼 회사에서 이제 막 머신러닝을 적용하려고 하는 분들에게 더 적합할 것 같습니다. 이 책이 서비스에서 활용되는 모델을 어떻게 관리하면 좋을 지에 대해 인사이트를 제공해 줄 것입니다. 보통 머신러닝 관련 책들은 모델링 관점에서 서술한 책이 주로 많은데, 이 책은 보안관점에서 자세하게 설명하고 있어서 좋았습니다. 기본적으로 이 책에서는 강화학습, 추천시스템처럼 널리 사용되지 않는 모델보다는 지도학습을 기반으로 모든 내용을 설명하고 있습니다.
책은 크게 3개의 파트로 나뉘어져 있습니다.
- Part 1 : 인공지능 위험관리의 이론과 실제 적용 사례
- 1장 : 현대의 머신러닝 위험관리
- 2장 : 해석 및 설명 가능한 머신러닝
- 3장 : 안정성과 성능을 높이는 머신러닝 시스템 디버깅
- 4장 : 머신러닝 편향관리
- 5장 : 머신러닝 보안
- Part 2 : 인공지능 위험관리 실행하기
- 6장 : 설명 가능한 부스팅 머신과 XGBoost 설명
- 7장 : 파이토치 이미지 분류기
- 8장 : XGBoost 모델 선택 및 디버깅
- 9장 : 파이토치 이미지 분류기 디버깅
- 10장 : XGBoost를 사용한 편향 테스트 및 개선
- 11장 : 레드 팀 XGBoost
- Part 3 : 결론
- 12장 : 고위험 머신러닝에서 성공하는 방법
2. 본문에 관하여
아무래도 이미 모델링을 하고 있는 분들을 대상으로 작성한 책이다 보니, 쉽게 읽히는 책은 아니었습니다. 만약, 처음 머신러닝을 접하시는 분이라면, 조금은 어렵다고 느낄 수 있을 것 같습니다. 기존 용어에 익숙하시다면, 쉽게 읽을 수 있겠지만, 아직 용어에 익숙하지 않다면, 시간이 꽤 걸릴 것 같습니다. 용어측면에서 번역을 해서 넣기는 했지만, 영어로 된 용어도 같이 작성해 줘서 영어 용어가 익숙한 저에게는 좋았습니다. 아무래도 전문적인 용어가 많이 있다 보니, 모든 용어를 세밀하게 첨부하기 어려운 점에서 현업하고 계신 분에게 적절할 것 같습니다.
이 책에서는 위에서 말씀드린 것처럼 생각보다 인사이트를 얻을 만한 요소가 많이 들어있습니다. 저의 경우에는 현업에서 머신러닝을 통해 예측하는 작업을 주로 진행하게 되는데, 기본적인 importance 외에도 SHAP 등과 같은 방법으로도 Feature들의 중요도를 알 수 있다는 점, 데이터 품질에 대해서 어떤 문제가 있을 때, 일반적인 증상과 해결방법을 알 수 있었습니다. 이러한 인사이트를 바탕으로 현재 우리의 상태에 대해 진단하고 데이터 품질을 올려야할 것인지에 대한 판단을 할 수 있습니다.
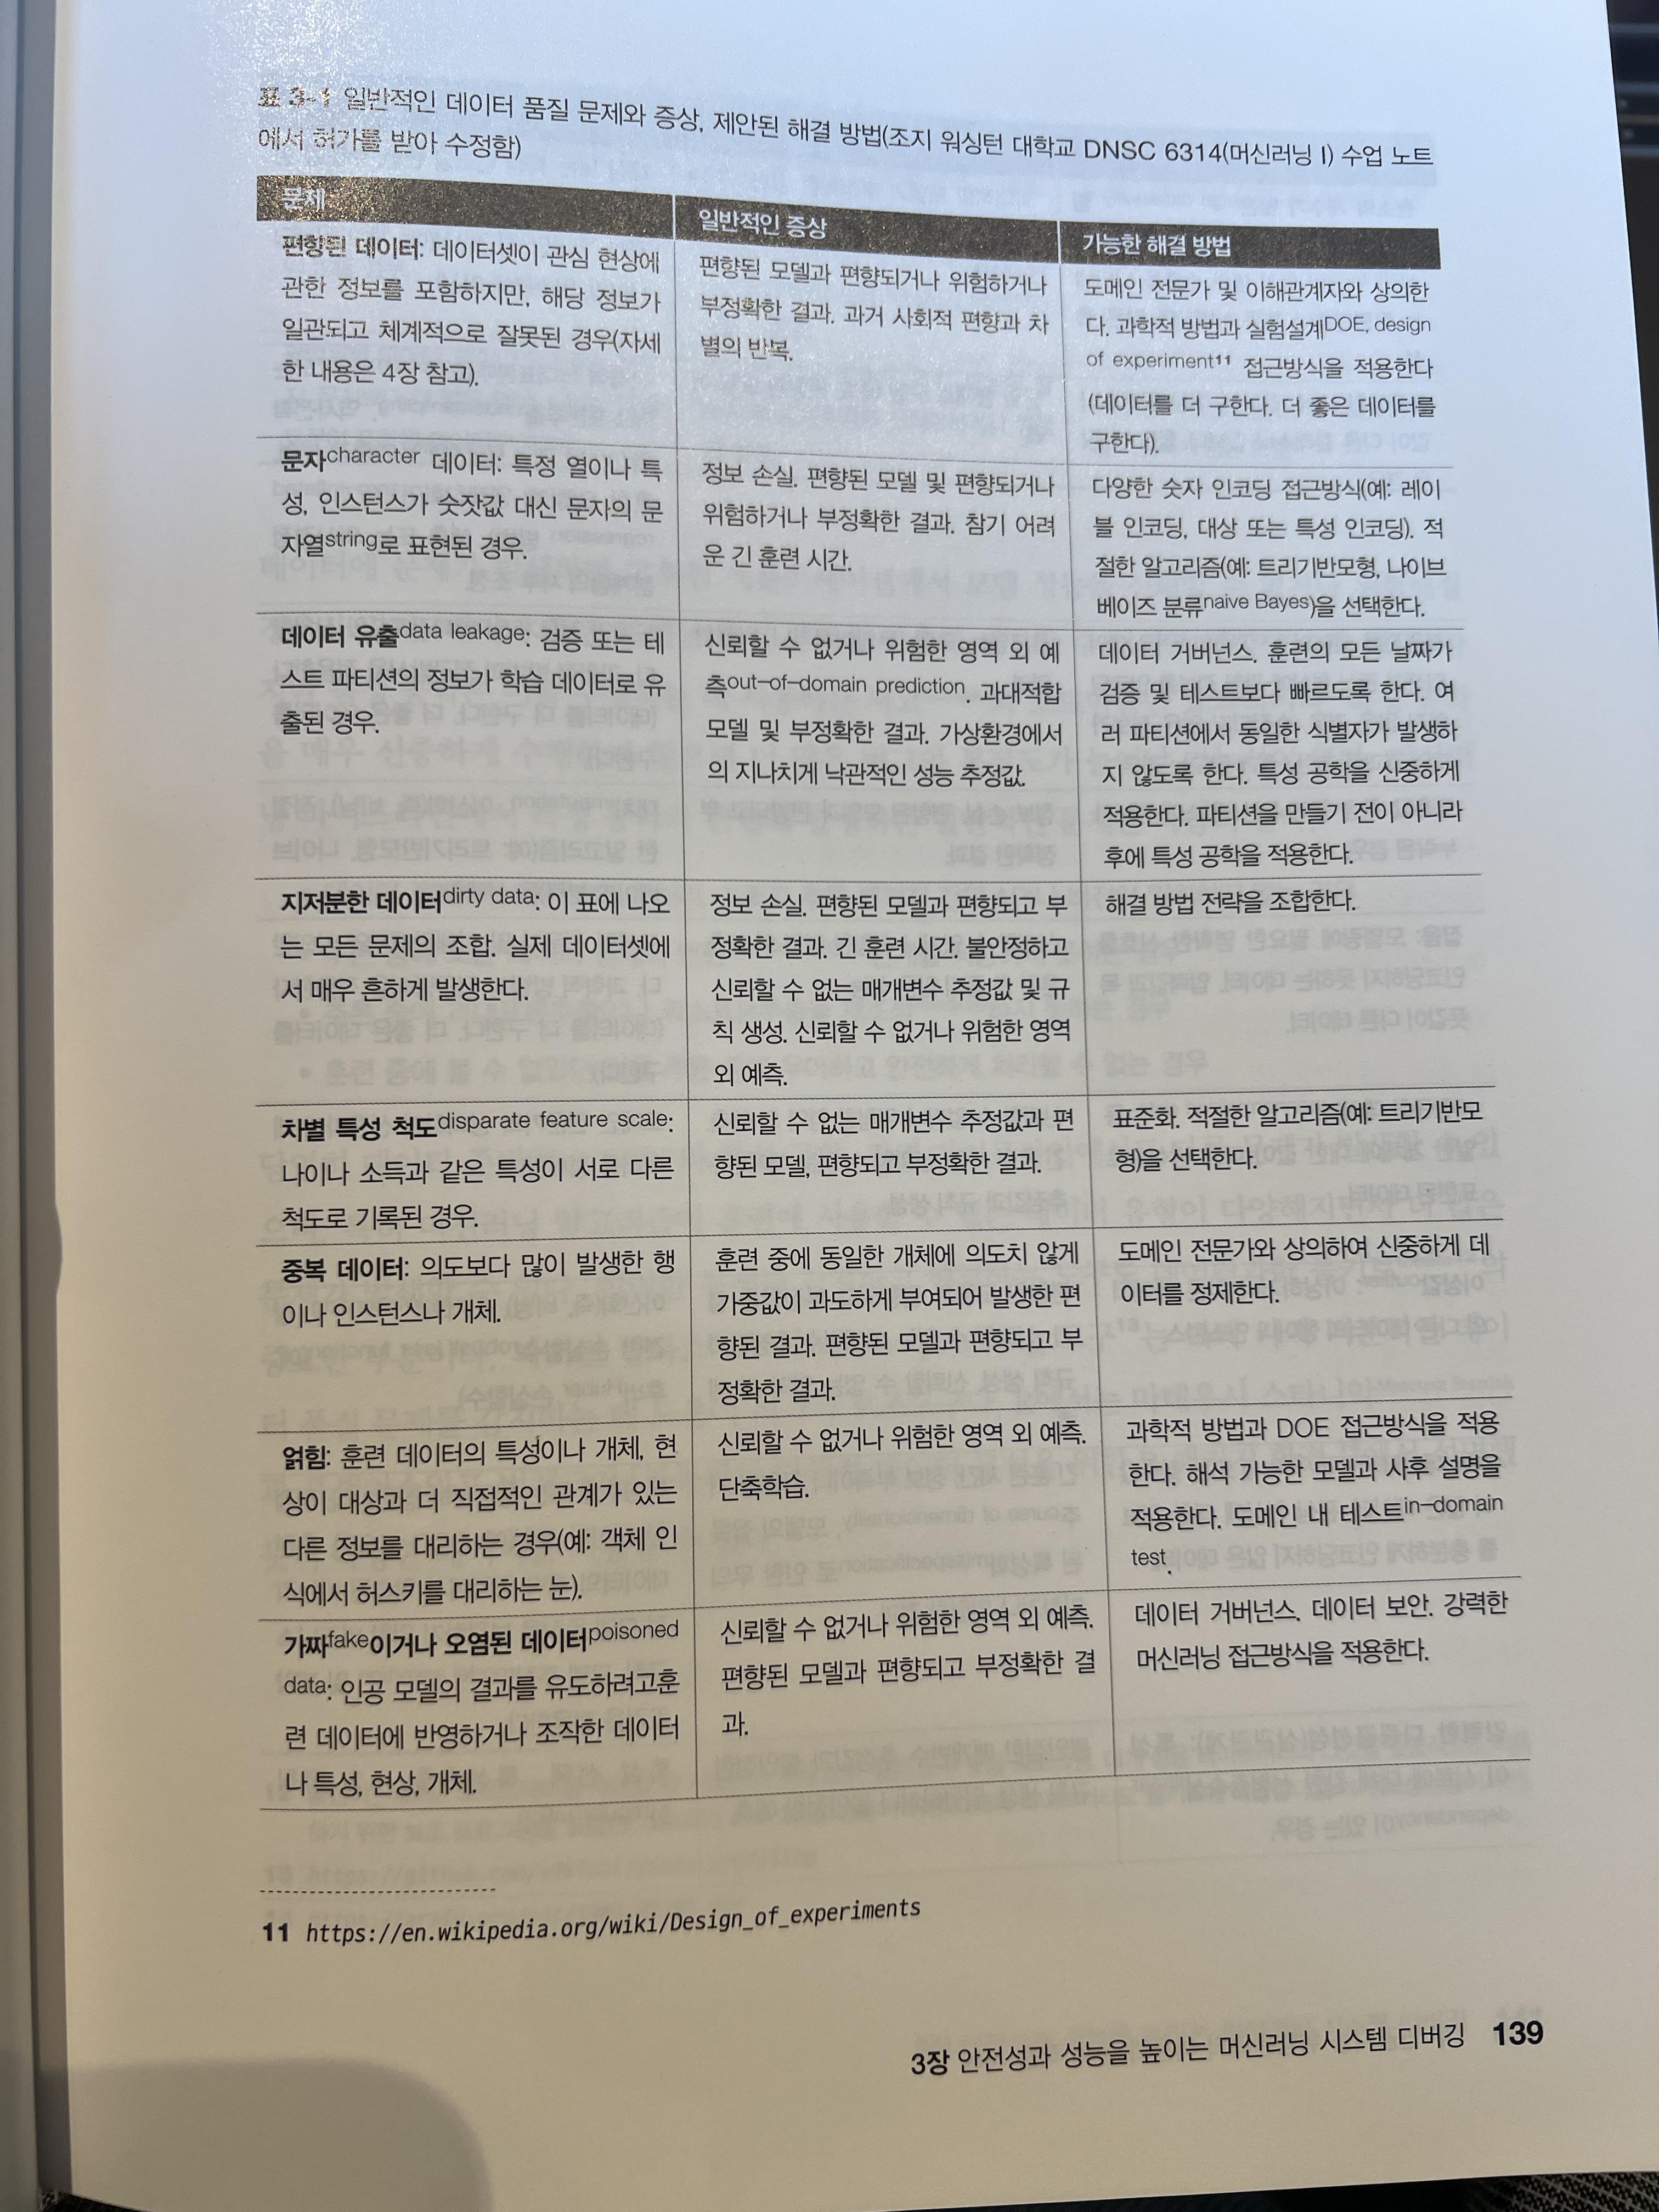
또한 모델링 이후 디버깅을 통해, 다양한 테스트와 논리적 오류, 부정확성, 보안 취약점을 찾는데 활용에 대한 디테일한 내용을 알 수 있었습니다.
3. 마무리하며
현업에서 우리 조직이 잘 해내고 있는 지를 체크할 수 있는 좋은 책이라고 생각합니다. 사실 머신러닝, 딥러닝은 모델링에 치우쳐서 얼마나 좋은 예측력을 내느냐에 집중하게 되는데, 실제 서비스 단에서 좋은 성능을 보이지 못하고 취약점이 발견되었을 때 더 큰 문제를 야기시킬 수 있습니다. 큰 기업에서는 이 책에 있는 것들을 잘 검증하고 있는 지를 체크해볼 수 있고, 초기 스타트업(모델링 단계)에서는 모델링 과정 및 배포 과정 등에 프로세스를 추가해 볼 만한 요소가 많은 책입니다. 고위험 머신러닝인 경우에는 특히나 이 책을 통해서 보완해야 하는 부분들을 체크해 볼 필요가 있습니다.


