독자리뷰
머신러닝의 기초부터 실무 적용까지 한 권에, 실무로 통하는 ML 문제 해결 with 파이썬
jinforea***
2024-05-25

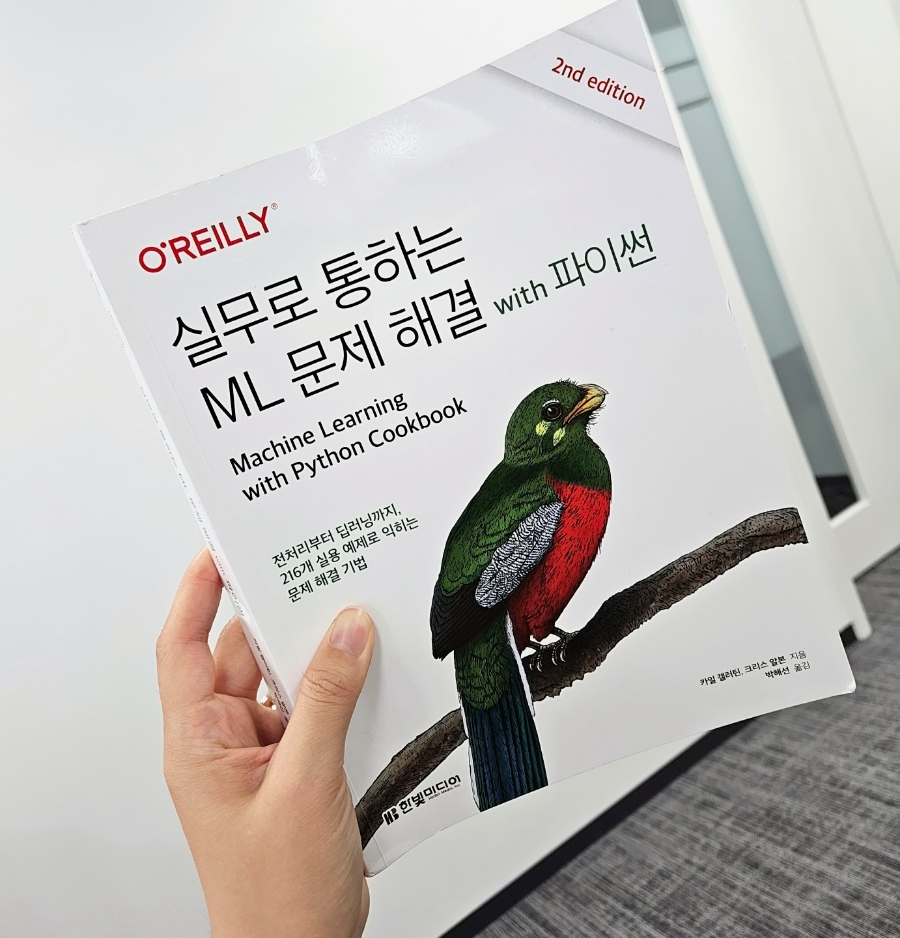
실무로 통하는 ML 문제 해결 with 파이썬
216개 레시피로 실전 머신러닝 문제를 쉽고 빠르게 해결하기
- 저자 : 카일 갤러틴 , 크리스 알본
- 번역 : 박해선
- 출간 : 2024-04-29
본 도서는 파이썬을 활용한 머신러닝 쿡북(2018)의 개정판으로,
2024년 4월 29일에 출간된 아주 따끈따끈한 도서입니다.
기존의 쿡북 도서는 충분히, 잘 테스트 된 파이썬의 레시피를 제공함으로써
실무자들이 코드를 자신의 문제에 맞게 간단히 조정하여 바로 사용이 가능했다고 합니다.
이미 그러한 편리함으로 눈도장을 찍은 저자 Kyle Gallatin은
5년간 빠르게 변화하고 발전한 머신러닝 및 딥러닝의
최신 python 라이브러리와 모델을 반영하게 되었다고 합니다.
데이터 전처리부터 딥러닝까지 총 216개의 실용적인 예제로
문제 해결 기법을 익힐 수 있도록 하고 있으며,
박해선 역자 분께서(혼공머신을 쓰신 분으로 알고 있는데, 이렇게 뵙니 반갑네요!!!)
원서의 부족한 내용을 보완하면서 대부분의 레시피에
'덧붙임' 항목을 만들어 새롭게 내용을 추가 및 보완하셨다는 점에서
실무로 통하는 ML 문제 해결 with 파이썬 만의 장점이 더 빛을 발하는 것 같습니다.
머신러닝의 시작은 누가 뭐라해도 벡터죠..
1장에서는 벡터, 행렬, 배열 등 선형대수의 기초 개념과
파이썬과의 연결부터 시작합니다.
아주 쉬운 개념같지만 선형대수에 대한 충분한 이해가 뒷받침되어야
이후 python에서 다양한 data type을 어렵지 않게 받아들일 수 있습니다.
2장에서는 다양한 data set 파일별 특성을 이해하고,
파일을 로드하는 방법을 가르쳐주고 있습니다.
특히 저는 얼마전에 알게 된 parquet 파일 적재하기 항목이 눈에 뜨네요
3장은 데이터 랭글링입니다.
생각보다 요 단어의 의미를 정확히 이해하지 못하고 계신 분들도 있는 것 같습니다.
데이터 랭글링은,
raw data를 머신러닝에 유용하게 사용할 수 있도록
형식을 변환하고 구조화하는 과정입니다.
Tidy Data, pandas의 reshape 함수 등을 사용하는 부분이겠죠!
4장, 5장은 수치형 데이터와 범주형 데이터입니다.
수치형 데이터의 경우 스케일링, 정규화, 특성 변환, 이상치, 누락값 처리를,
범주형 데이터의 경우 순서의 유무에 따른
인코딩, 누락값 처리, 불균형 클래스 처리 등에 대한 가이드를 해주고 있습니다.
6장은 텍스트 다루기 항목입니다.
제목을 쉽게 작성해주셨지만,, 사실 텍스트 데이터 역시 분석이 쉽지 않습니다.
개념적으로는 익숙하지만, 자연어 처리는 실제로 분석했을 때
고려해야 할 부분이 너무 많아 어려운 것 같습니다.
해당 챕터에서는 텍스트 정제, 파싱,토큰화, 불용어, 어간 추출, 품사 태깅, 가중치, 유사도 계산 등
감성 분석의 전반적 플로우를 담고 있습니다.
7장에서는 날짜, 시간 데이터와 같은 시계열 데이터를 다루고 있습니다.
시간의 흐름이 분석에서 중요하게 다뤄지는 시계열 데이터의 특성과
날짜간의 차이, 요일, 시차 특성 등 발생가능한 다양한 분석 피쳐를 생성해볼 수 있습니다.
8장은 이미지 다루기 챕터입니다.
어렵죠.......
하지만 본 책에서는 이미지 로드, 저장, 크기 변경, 크롭 등 매우 간단한 작업부터
대비 높이기, 색깔 구분하기, 이미지 이진화, 배경 제거, 모서리 감지 등등
머신러닝에서 사용할 수 있는 다양한 핸들링 작업을 가르쳐 주고 있습니다.
OpenCV를 다루고 있기는 하지만,
책의 이름 답게 머신러닝에 초점을 맞추어
딥러닝 분석법을 최대한 다루지 않으려고 노력한 부분이 마음에 들었습니다.
10장의 특성 선택을 차원 축소로
수치 특성, 이진 특성, 상관관계가 큰 특성 등을 다루는 법을 배운 뒤에는
11장, 12장에서는 모델 평가 및 모델 선택을 다루고 있습니다.
데이터 분석에서는 분석도 중요하지만 모델링하는 과정이 너무 중요하죠.
교차 검증 모델, 기본 회귀/분류 모델 생성부터 평가라는 기초 개념부터
하이퍼파라미터 조정, 그리고 본 책에서는 신선하게
하이퍼파라미터 값의 영향을 시각화하는 방법을 가르쳐 주고 있습니다.
모델 선택 챕터에서는 다양한 탐색법을 사용해 각 분석에 맞는 모델을 선택하는 방법,
모델 선택 속도를 높이는 법, 모델 선택 후 성능 평가법 등 팁을 담고 있습니다.
13장부터는 머신러닝에서 사용되는 다양한 모델과 알고리즘을 다루고 있습니다.
각 챕터에서 다루는 모델을 말씀드리자면 다음과 같습니다.
선형회귀(13장)는 데이터의 선형 관계를 모델링하는 데 사용되고,
트리와 랜덤 포레스트(14장)는 의사 결정 트리를 기반으로 한 모델로,
복잡한 관계를 다루거나 다수의 의사 결정 트리를 결합하여 예측을 개선합니다.
K-최근접 이웃(15장)은 주변 데이터의 근접성을 기반으로 예측을 수행하며,
로지스틱 회귀(16장)는 범주형 데이터를 처리하는 데 사용됩니다.
서포트 벡터 머신(17장)은 데이터를 분류하기 위해
고차원 공간으로 매핑하는 데 사용되는 알고리즘입니다.
나이브 베이즈(18장)는 베이즈 이론을 기반으로 하는 간단한 분류 알고리즘이며,
군집(19장)은 데이터를 유사한 그룹으로 묶는 데 사용됩니다.
목차를 이렇게 적다 보니,, 안 중요한 부분이 없네요 하하
데분러라면,, 다 보셔야 합니다..
그래도 이렇게 한 권에 실습까지 담겨 있어 여러 권을 안 봐도 되는 게
얼마나 편리하고 좋나요!!!
20장은 파이토치 텐서를 다루는 법입니다.
텐서를 생성하고, 구조를 파악하고, 전치, 펼치기, 점곱 계산, 곱셈 계산을 배우는데
저는 텐서를 다뤄본 적이 없어 매우 생소하게 느껴졌으나
결국 대수를 다룬다 생각하면 원리는 비슷한 것 같습니다.
이제 끝이 보입니다!
21장에서는 신경망에 대한 이해와 훈련,
그리고 다양한 방식을 통한 과대적합 방지를 배운 후에
앞에서 배운 신경망을 튜닝하고, 시각화하는 방법을 배웁니다.
이어서 22장에서는 이 신경망 훈련을 비정형 데이터를 대상으로 적용해보고,
마지막 23장에서는 훈련 모델을 저장, 로드, 서빙하는 가이드를 하고 있습니다.
(사이킷런, 텐서플로, 파이토치 모델)
사실,, 전 학부 졸업까지 이 서빙하는 방식을 정확히 이해하지 못해
맨날 코랩 돌릴 때마다 모델링 다시해서 모델을 사용했는데
이,, 부분을 알았으면 얼마나 좋았을까요..^^
생각보다 훈련 모델을 저장하고 적재, 서빙하는 방법을 알려주는 책이 많이 없는 것 같아
이 책의 장점이 또 23장에 있다고 생각합니다.
저처럼 애매하게 머신러닝의 전반적인 이해는 있으나
그간 들어온 다양한 용어, 방법론에 대한 개념 정립이 필요하신 분들께서는
머신러닝에 대한 이해와 정립을 하는 동시에
문제풀이로 실전에 응용하면서 읽어보시는 것을 추천드립니다.
한 번 이렇게 한 권의 책으로 단권화 후
바로 다음 분석 프로젝트에 투입됐을 때
바로 활용이 가능할 정도로 충분히 자세하게 작성되어 있어
말 그대로 머신러닝 쿡북의 선두주자
"실무로 통하는 ML 문제 해결 with 파이썬" 이었습니다!