독자리뷰
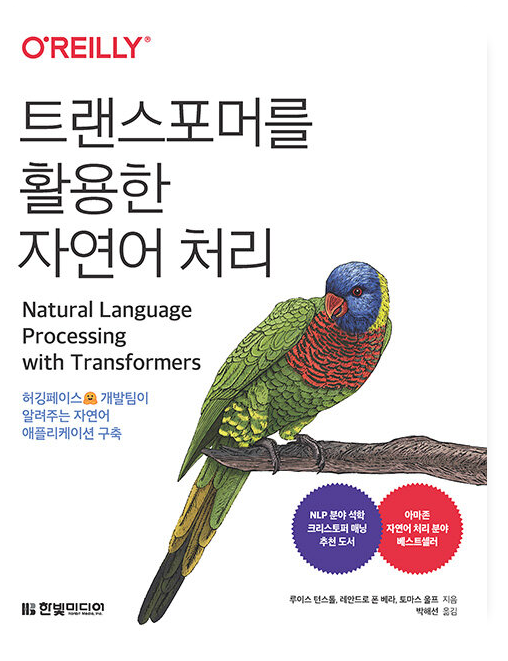
트랜스포머를 활용한 자연어 처리
moonlight***
2022-12-19

트랜스포머를 활용한 자연어 처리
챗GPT처럼 자연어를 찰떡같이 알아듣는 트랜스포머 완벽 해부
- 저자 : 루이스 턴스톨 , 레안드로 폰 베라 , 토마스 울프
- 번역 : 박해선
- 출간 : 2022-11-30
한빛미디어 '나는 리뷰어다' 활동을 위해서 책을 제공받아 작성된 서평입니다.
0. 소개
Image 분야의 Deep Learning에 CNN 구조가 있다면, Text 분야의 Deep Learning에서의 대세는 역시 Transformer입니다.
2017년에 Google에 의해 'Attention Is All You Need' Paper가 발표되고 난 후, NLP 분야는 Transformer로 인해 그야말로 비약적인 발전을 이루게 됩니다.
Paper 발표 이후, Text Classification , Summarization , Translation , QA, NLU , NER 등 모든 Text 관련 부분에서 SOTA를 이루어 냈고, 지금도 그 위력은 여전합니다.
Transformer 구조 자체가 약간 어려운 느낌은 있지만, 대중화시킨 것은 HuggingFace의 역할이 큽니다.
누구나 Transformer 구조를 Base로 한 Pre-Trained Model을 검색하고 다운로드할 수 있으며,
Fine Tuning 하여 자신의 Project에 적용할 수 있도록 도와줍니다.
이 책은 Transformer 개발자와 HuggingFace 개발자들이 공동 집필, 이를 둘러싼 생태계까지, 전 영역을 다룹니다.
모든 주제가 실습 위주 방식이고, 주피터 노트북을 제공하기 때문에 직관적이며 이해하기 쉽습니다.
또한, 통찰력 있는 설명과 실질적 애플리케이션에 대해서 다루기 때문에 매우 실용적입니다.
Transformer를 기초부터 설명하고 실전에 사용할 수 있도록 Guide를 제시하고 있기 때문에, NLP를 처음 배우는 사람이든 전문가이든 Model을 빠르게 개발하고 배포할 수 있도록 도와줍니다.
책에는 실전에서 만날 수 있는 난관(처음부터 Model을 훈련시켜야 한다든지 Label이 있는 Dataset이 없다든지...)에 대응할 수 있는 실용적이고 즉시 사용 가능한 Solution도 제공합니다.
번역가(박해선 님)의 전문성에서 우러나오는 물 흐르는 듯한 부드러운 문장이 읽기 편하고 이해가 쉽다는 것도 장점입니다.
이 책은 현재 구할 수 있는 Transformer의 Guide 중 최고라고 생각합니다.
1. 구성
CHAPTER 1 트랜스포머 소개
- 흔히 Seq-To-Seq 방식이라고도 알려진 Encoder - Decoder Framework에 대한 소개
- Attention의 장점과 Attention이 어떤 방식으로 기존 방식들의 문제점들을 개선하는지 소개
- HuggingFace 소개 및 장점
CHAPTER 2 텍스트 분류
- DistilBERT를 이용한 텍스트 분류 작업을 해보면서 HuggingFace 사용법을 익힌다.
- HuggingFace에서 Dataset을 검색하고 다운로드 / Pre-Processing / EDA하는 방법 소개
- Feature Extractor로 사용하기 / Pre-Trained Model 사용법 / Fine Tuning 방법
CHAPTER 3 트랜스포머 파헤치기
- Transformer의 실질적인 구현을 알아본다.
- Transformer Model의 구분 : Encoder 유형 / Decoder 유형 / Encoder - Decoder 유형
- 다양한 Transformer Base Model들의 분류 및 소개
CHAPTER 4 다중 언어 개체명 인식
- 영어 이외의 다른 언어에서 Transformer 적용 방법을 NER을 통해서 알아본다.
- Transformer를 임의의 NLP 작업에 적용해 보기
- Body - Head 구조로 인해서 쉽게 어디든지 적용가능하다는 것을 확인
- 하나의 언어에서 학습한 Model을 다른 언어에도 적용해보는 방법을 알아보자
CHAPTER 5 텍스트 생성
- GPT-2를 이용한 Text Generation 예제를 살펴본다.
- Greedy Search 방식의 작동 방법과 문제점 그리고 그 대안과 Beam Search Decoding
- Decoding 방법과 선택에 대한 가이드
CHAPTER 6 요약
- Seq. To Seq. Model(Encoder - Decoder)과 CNN/DailyMail Dataset을 이용하여 문장을 요약하는 방법
- Baseline Model 선정 및 Model을 이용하는 방법 ( BART / GPT-2 / T5 / PEGASUS )
- 다양한 Text Summarization 품질 평가 / 방법 소개 ( BLEU / ROUGE )
- PEGASUS의 Fine Tuning 방법 소개
CHAPTER 7 질문 답변
- Text 일부를 답변으로 추출하는 방법.
- 문서(Web Page , 계약서 , News)에서 원하는 답을 찾는 방법 확인
- 수많은 Review 중 특정 질문에 대한 답을 찾는 방법 소개
- QA를 NLP 문제로 해결하기 위한 방안 모색
- Base Model을 어떤 Model로 선택할지 Guide
- Tokenizer for QA Model
- 리트리버 / 리더 평가 방법
- 추상적(Abstractive) or 생성적(Generative) QA 소개
- RAG 소개
CHAPTER 8 효율적인 트랜스포머 구축
- Transformer 성능 향상을 위한 기법들 소개
- 질문의 의도를 파악하는 Model
- Model 배포시에 염두해야할 사항들 ( 성능 , Latency , Memory 등 )을 확인할 수 있는 방법
- 지식 정제 : 느리고 크지만 성능이 더 좋은 Teacher의 동작을 모방하도록 작은 Student Model을 훈련하는 전반적인 방법 소개
- Weight & Output Format으로 Int로 바꾸는 양자화
- ONNX로 성능 향상 시키기
- Memory가 부족한 경우에 속도 향상을 이룰 수 있는 방법
- 중요하지 않는 가중치를 줄이는 방법에 대해서 알아본다.
CHAPTER 9 레이블 부족 문제 다루기
- Labeled Data가 없거나 매우 적은 경우에 대한 Guide
- Baseline Model로 Naive Bayes을 준비한다.
- Labeled Data가 없는 경우 처리 방법 소개
- Data Augmentation 방법 소개
- Labeling 되지 않는 Data를 활용하는 방법 소개
CHAPTER 10 대규모 데이터셋 수집하기
- 원하는 Data가 모두 있는 경우에 어떤 일을 할 수 있는지 알아보자
- 사전 훈련을 위해서 대규모 말뭉치부처 만드는 다양한 방법들을 소개한다.
- Customized Tokenizer를 구축하는 방법 , 성능 측정 방법 , 훈련 방법 소개
- Model 초기화 / Data Loader 구축하기 / Train Arguments 설정 방법
CHAPTER 11 향후 방향
- Transformer가 강력하지만 현재 당면한 과제들이 어떤 것이 있는지 알아보고 연구동향을 살펴보자
- 기존의 성능이 우수한 Model들을 성능을 향상시키는 방향으로 발전시키는 방안에 대해서 모색한다.
- Text Data 뿐만 아니라, Image , Table Data 등과 같은 Data를 활용하는 방안
- 일반적인 Text Data 뿐만 아니라 Audio Text , Vision Text 등과 같이 두 개의 Data 형식을 합치는 방안에 대한 검토
2. 대상 독자
저는 이 책을 Transformer라는 Model은 알고 있지만, 이 Model을 실제 Application에 적용할 자세한 Guide가 필요한 개발자 혹은
어느 정도 Deep Learning Framework에 경험이 있지만, 자신만의 Project에 Transformer를 적용하려고 하는 개발자들에게 추천합니다.


