독자리뷰
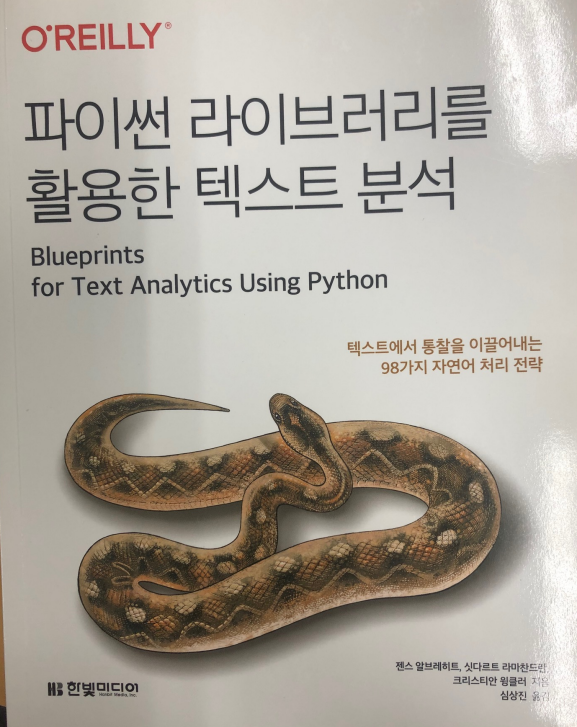
파이썬 라이브러리를 활용한 텍스트 분석
moonlight***
2022-11-16

파이썬 라이브러리를 활용한 텍스트 분석
분석하려는 텍스트에 맞는 처리 기법을 소개하는 도서로 실제 모범 사례를 기반으로 상황에 맞게 설계한 텍스트 전처리 파이프라인 구축, N-그램 분석, 텍스트 벡터화 등 다양한 전략과 그때 필요한 파이썬 라이브러리를 소개한다.
- 저자 : 젠스 알브레히트 , 싯다르트 라마찬드란 , 크리스티안 윙클러
- 번역 : 심상진
- 출간 : 2022-10-11
한빛미디어 '나는 리뷰어다' 활동을 위해서 책을 제공받아 작성된 서평입니다.
0. 소개
요즘에는 Machine Learning / Deep Learning이 일상생활에 알게 모르게 스며들어 있고, 누구나 배우고자 한다면 매우 다양한 자료를 접할 수 있습니다.
Deep Learning 분야에서 가장 먼저 큰 진전을 이루었던 것이 Image 분야이지만, 시각적인 인공지능 못지않게 인간들에게 중요한 것이 글로 쓰인 Data 즉, Text Data입니다.
NLP(Natural Language Process)를 다루는 수많은 동영상 강의, Technical Blog 등에서는 가장 기초적인 부분에서부터 최신 트렌드를 반영하는 주제까지 모두 다루고는 있습니다.
하지만, 정작 실무에 적용하려고 하면 막막한 것이 현실입니다.
정작 내가 풀려고 하는 문제에는 어떤 Model을 적용해야 하고, Text Data Preprocessing은 어떤 식으로 하면 좋은지 전혀 감이 잡히지 않습니다.
더욱더 어려운 점은 어떤 Dataset을 어떻게 구해야 하는 지도 모르는 상황인 것입니다.
이 책은 이런 문제들에 대해서 가장 좋은 대답을 제시해 줍니다.
다양한 Model을 문제에 맞게 빠르게 적용해 볼 수 있는 간단한 Code들을 제시해 주며, 필요한 Dataset을 어떻게 구할 수 있는지도 상세하게 알려줍니다.
뿐만 아니라, 각 Chapter마다 중요한 읽을거리도 제공해 줍니다. 이는 주제에 대한 배경지식을 더욱더 넓혀주는 유용한 정보가 많이 포함되어 있습니다.
또한, 매 Chap마다 다른 실제 Dataset을 사용하여 Project를 진행하기 때문에 실용적이며 현실적입니다.
실제 Project에 바로 사용할 수 있는 Dataset을 Web에서 수집하는 실용적인 방법을 소개하는 Chapter도 포함되어 있습니다.
기초적인 Text 처리에 대한 개론부터 고전적 Machine Learning / Deep Learning에 사용하는 기법 소개 및 활용 방안 소개되어 있고, 현재 실제도 많이 사용되는 최신 Algorithm / Solution도 소개하고 있습니다.
다만, 몇 가지 단점이라면 최신 NLP 기술을 다루는 것에는 상대적으로 취약하고 Deep Learning 기법보다는 주로 Machine Learning 내용이 많으며 사용하는 Model이나 Text Dataset이 영어라는 점입니다.
1. 구성
CHAPTER 1 Text Data에서 찾는 통찰
- Text Data의 통계적 탐험 시작
- Text Data를 다루는 데 있어서 기본적인 방법들을 소개한다.(Tokenization , 빈도 Diagram, Word Cloud , TF-IDF)
CHAPTER 2 API로 추출하는 Text 속 통찰
- 인기 있는 API에서 Data를 추출하는 다양한 Python Module 사용
- Text Data 분석에 사용할 Dataset을 다양한 경로(Github , 트위터 등)에서 추출하는 방법에 대해서 알아본다.
- 특정 API를 사용하여 유용한 Dataset을 만드는 방법을 알아본다.
CHAPTER 3 Web Site 스크래피 및 Data 추출
- 웹 페이지 다운로드, 콘텐츠 추출 전용 Python Library 사용
- HTML Data를 얻고 도구를 통해 콘텐츠를 추출하는 방법에 대해서 알아본다.
CHAPTER 4 통계 및 머신러닝을 위한 Text Data 준비
- Data 정리와 언어 처리 소개
- Data Preprocessing 파이프라인 개발
- Data 셋 : 레딧 셀프 포스트
- Token 화를 포함한 기본적인 Text Data Preprocessing 기법 소개
- Text Data를 생성하는데 필요한 Solution 제공
- 정규화 방식 제안
CHAPTER 5 Feature Engineering 및 구문 유사성
- 특성과 Vector 화 소개
- 문서 유사도 측정
- 문서 -> Vector 변경 시에 매우 다양한 변환 방법 소개
CHAPTER 6 Text 분류 Algorithm
- 머신러닝 Algorithm을 사용해 소프트웨어 버그를 분류하는 Text 분류기 Algorithm
- 지도학습 기반 Text 분류 Model을 사용해 SW 버그를 분류하는 Text 분류 Algorithm
- JDT Bug Report Dataset을 사용
- Data 준비, Vector 화, 분류기 결정, Train , Hyperparameter 조정 등 실제 쓸만한 Model 생성을 자세하게 소개
CHAPTER 7 Text 분류기
- Model 및 분류 결과 설명
- Model이 결정을 내린 이유를 확인하는 방법
- 설명 가능한 Model은 아직 신생 분야
CHAPTER 8 비지도 학습: Topic Model 링 및 Clustering
- 비지도 학습으로 Text에서 편향 없는 통찰 획득
- 다양한 Topic Model 링 방법과 구체적인 장단점 확인(NMF(비음수 행렬 분해), 특잇값 분해(SVD), 잠재 디리클레 할당(LDA) )
- 유엔 총회 일반 토의 Dataset 사용
CHAPTER 9 Text 요약
- 규칙 기반과 Machine Learning 방식을 사용한 뉴스와 포럼 타래 글의 요약 생성
- 입문 단계의 Text 요약 기술을 알아본다. ( 추출 방법 / 추상화 방법 )
- LSA / TextRank 등의 기본적인 사용법 학습
CHAPTER 10 단어 Embedding으로 의미 관계 탐색
- 단어 Embedding을 사용한 특정 Data 셋의 의미적 유사성 탐색과 시각화
- 기존에 사용하던 TF-IDF의 단점을 알아보고, 이를 개선한 다른 Embedding 방식을 알아본다.
- Word2Vec , FastText , GloVe
CHAPTER 11 Text Data를 이용한 감성 분석
- 아마존 상품 리뷰에서 소비자의 감성 식별
- Text Data에서 감성을 구분하는 Model을 학습한다.
- 간단한 규칙을 기반으로 하는 Model에서 최신 BERT를 이용한 Model까지 활용하는 방법을 알아본다.
CHAPTER 12 지식 그래프 구축
- 사전 훈련된 Model과 사용자 규칙을 사용해 명명된 개체와 개체의 관계 추출
- Python의 고급 언어 처리 기능을 이용하여 개체명 인식(NER, Named-Entiry Recognition) , 상호 참조 해결(Coreference Resolution) , 관계 추출(Relation Extraction)을 위한 사용자 지정 규칙과 함께 사전 훈련된 신경망 Model을 사용하는 방법을 학습 나다.
CHAPTER 13 프로덕션에서 Text 분석
- Google Cloud Platform에서 감성 분석 서비스를 API로 배포 및 스케일링
- REST API를 사용하여 학습된 결과를 공유하거나 배포하는 방법에 대해서 알아본다.
- Linux Shell or Windows PowerShell에서 잘 작동하는 방법으로 작성한다.
- Conda / Docker 등을 이용하는 방법을 알아본다.
2. 대상 독자
이 책은 다음과 같은 독자에게 추천드립니다.
- Text를 이용한 Machine Learning / Deep Learning Project를 수행하여야 하지만 기초가 부족하다고 느끼는 독자
- 최신의 Transformer와 같은 Model에 대해서 공부하였지만, 정작 실제 Data를 어떻게 구하고 Machine Learning / Deep Learning에 입력해야 하는지 감이 잡히지 않으신 분들
- Sample 결과를 빠르게 만들어 Project 성공 가능성을 확인하려는 독자
- 문제를 풀기 위한 Baseline을 빠르게 작성해야 하는 독자


