독자리뷰
[서평] 그로킹 심층 강화학습
wltk***
2022-08-28


목차
CHAPTER 1 심층 강화학습의 기초
1.1 심층 강화학습이란 무엇인가?
1.2 심층 강화학습의 과거와 현재 그리고 미래
1.3 심층 강화학습의 적절성
1.4 두 가지의 명확한 기대치 설정
1.5 요약
CHAPTER 2 강화학습의 수학적 기초
2.1 강화학습의 구성 요소
2.2 MDP: 환경의 엔진
2.3 요약
CHAPTER 3 순간 목표와 장기 목표 간의 균형
3.1 의사결정을 내리는 에이전트의 목적
3.2 이상적인 행동들에 대한 계획
3.3 요약
CHAPTER 4 정보의 수집과 사용 간의 균형
4.1 평가가능한 피드백 해석의 어려움
4.2 전략적인 탐색
4.3 요약
CHAPTER 5 에이전트의 행동 평가
5.1 정책들의 가치를 추정하는 학습
5.2 여러 단계를 통해서 추정하는 학습
5.3 요약
CHAPTER 6 에이전트의 행동 개선
6.1 강화학습 에이전트의 구조
6.2 행동에 대한 정책을 개선하기 위한 학습
6.3 학습에서 행동을 분리하기
6.4 요약
CHAPTER 7 조금 더 효율적인 방법으로 목표에 도달하기
7.1 강건한 목표를 활용한 정책 개선 학습
7.2 상호작용, 학습 그리고 계획하는 에이전트
7.3 요약
CHAPTER 8 가치 기반 심층 강화학습 개요
8.1 심층 강화학습 에이전트가 사용하는 피드백의 유형
8.2 강화학습을 위한 함수 근사화
8.3 NFQ: 가치 기반 심층 강화학습을 위한 첫 번째 시도
8.4 요약
CHAPTER 9 조금 더 안정적인 가치 기반 학습 방법들
9.1 DQN: 강화학습을 지도학습처럼 만들기
9.2 이중 DQN: 행동-가치 함수에 대한 과도추정 극복
9.3 요약
CHAPTER 10 샘플 효율적인 가치 기반 학습 방법들
10.1 듀얼링 DDQN: 강화학습에 초점을 맞춘 신경망 구조
10.2 PER: 유의미한 경험 재현에 대한 우선순위 부여
10.3 요약
CHAPTER 11 정책-경사법과 액터-크리틱 학습법
11.1 REINFORCE: 결과기반 정책 학습
11.2 VPG: 가치함수 학습하기
11.3 A3C: 병렬적 정책 갱신
11.4 GAE: 강력한 이점 추정
11.5 A2C: 동기화된 정책 갱신
11.6 요약
CHAPTER 12 발전된 액터-크리틱 학습법
12.1 DDPG: 결정적 정책에 대한 근사화
12.2 TD3: DDPG를 넘어선 성능을 보이는 개선점들
12.3 SAC: 기대 반환값과 엔트로피를 최대화하기
12.4 PPO: 최적화 과정을 제한하기
12.5 요약
CHAPTER 13 범용 인공지능을 향한 길
13.1 다룬 내용과 다루지 못한 내용
13.2 범용 인공지능에 대한 조금 더 발전된 개념들
13.3 이후의 내용들
13.4 요약
본문

▶ 강화학습과 관련된 수학 공식부터 코드 예제까지 자세한 설명 수록
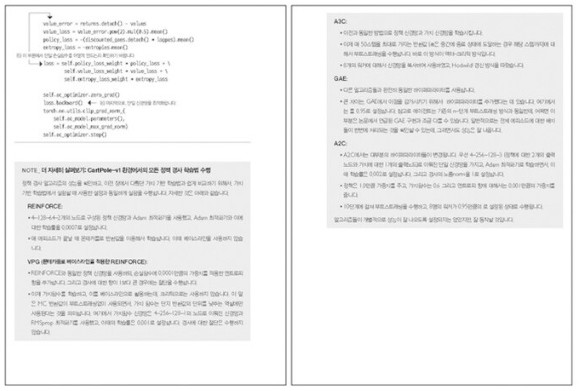
▶ '더 자세히 살펴보기' 코너를 통해 핵심 내용 혹은 심화 내용 수록
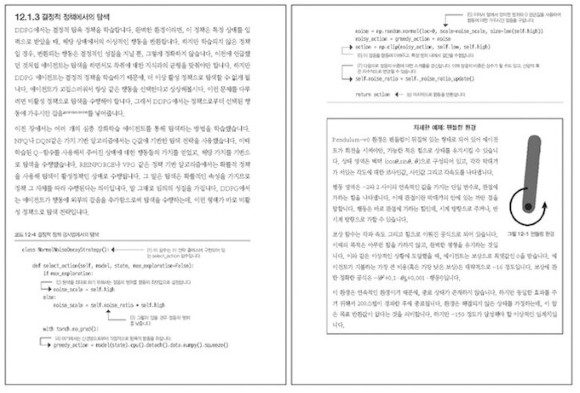
▶ 각 장마다 개념 설명에 있어 예시, 삽화, 실습등을 사용하여 독자들에게 강화학습을 쉽게 이해할 수 있도록 하였다.
책의 특징
· 심층 강화학습의 기본 원리를 다양한 예시로 쉽게 접근 할 수 있습니다.
· 수학 개념 및 예시 등을 통해 심층 강화학습을 다양한 관점에서 접근 할 수 잇습니다.
· 수학 공식 및 코드 예제 까지 수록하여 이론 및 적용 방법까지 안내하였습니다.
추천 독자
· 심층 강화학습에 입문 하고자 하는 개발자
· 인공지능에 대해 모르더라도, 파이썬 코드를 읽을 줄 알고 강화학습에 흥미있는 누구나
"한빛미디어 <나는 리뷰어다> 활동을 위해서 책을 제공받아 작성된 서평입니다."


