독자리뷰
배운 머신러닝을 실무에 써보아야 해!
qorskawls***
2022-04-17

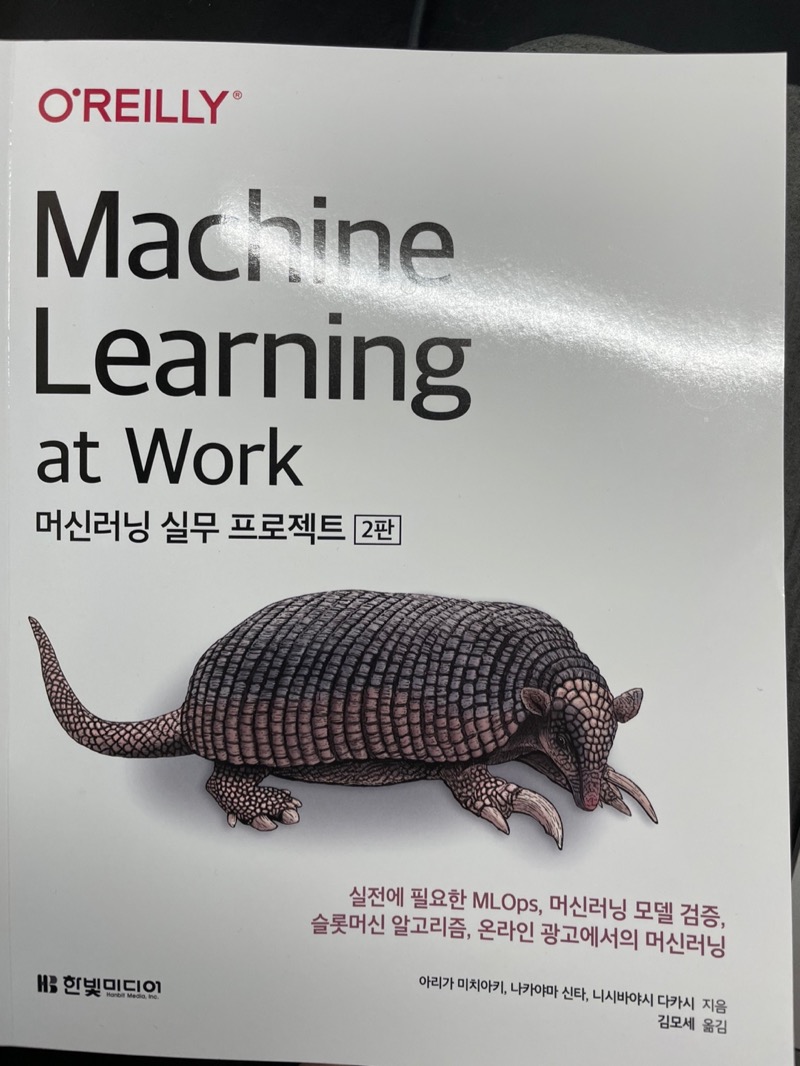
머신러닝 실무 프로젝트(2판)
머신러닝 프로젝트를 처음 시작하는 방법, 기존 시스템에 머신러닝을 통합하는 방법, 머신러닝에 사용할 데이터를 수집하는 방법 등 실무에 유용한 내용을 중점적으로 다룬다.
- 저자 : 아리가 미치아키(有賀 康顕) , 나카야마 신타(中山 心太) , 니시바야시 다카시(西林 孝)
- 번역 : 김모세
- 출간 : 2022-03-10
본 도서는
"한빛미디어 <나는 리뷰어다> 활동을 위해서 책을 제공받아 작성된 서평입니다."
이 책은 실제 비지니스에 머신러닝을 어떻게 적용할 것인지, 어떤 경우에 머신러닝 기법과 데이터 분석 방법을 적용해야하는지 알려준다.
머신러닝을 공부한 사람은 한 번쯤은 고민해보았을 것이다.
"Iris Datasets, Wine Datasets, Penguin Weights Datsets 등으로 머신러닝을 했는데,
실전 프로젝트에서는 어떻게 사용되는걸까?"
이 책은 그런 가려운 고민들을 긁어준다.
.
.
.
시스템 운용 및 문제해결 방법과 과적합 등을 어떻게 해결하는지 알려준다.
Classification, Regression Metrics에 대한 개념도 알려주는데 수식과 함께 2~3줄의 개념설명 그리고 코드를 작성하여 개념을 빠르게 상기시켜준다.
그러고 그런 Metric을 실전 프로젝트에 적용해봄으로써 실무 프로젝트 다루기에 한 층 업그레이드 해준다.
.
.
.
필자는 특히 Chapter 7, 효과 검증 부분을 반복적으로 읽어보았다.
"새로운 정책 덕분에, 지난 주보다 매출이 20% 상승했다!"
이것이 인과관계로 이어지는 것이 맞을까?
사실 우리는 이런 효과를 검증하기 위해서는 고려할 것이 많다.
잠재변수는 고려했는가? 교란 요인은 없는가? 모집단의 특성을 대표하는 표본을 두고 실험을 했는가?
통제 요인은 잘 다루었는가? 상관관계를 인과관계로 인식한 것은 아닌가?
이 챕터에는 효과적인 정책을 판단하기 위해서 실험법, 선택 편향, 가설검정 알려준다.
통계를 하는 사람에게도 좋은 책일 것이며, 머신러닝, AI만 다룬 사람들에게도 많은 도움이 될 것이라 생각한다.
다만 반사실 다루기, Off Policy Evaluation, 차이의 차이 등 생소한 단어들을 많이 접할 것이다.
그러나 걱정할 필요없다.
스토리텔링과 상황 시뮬레이션을 통해서 실전과 같은 느낌을 들게 하여 각 단어의 의미를 바로 이해하게 해준다.