독자리뷰
실제 데이터 환경에 초점을 맞춘 실무 지침서! 입문서로 접근하면 조금은 힘들수도...
minki1***
2021-12-26

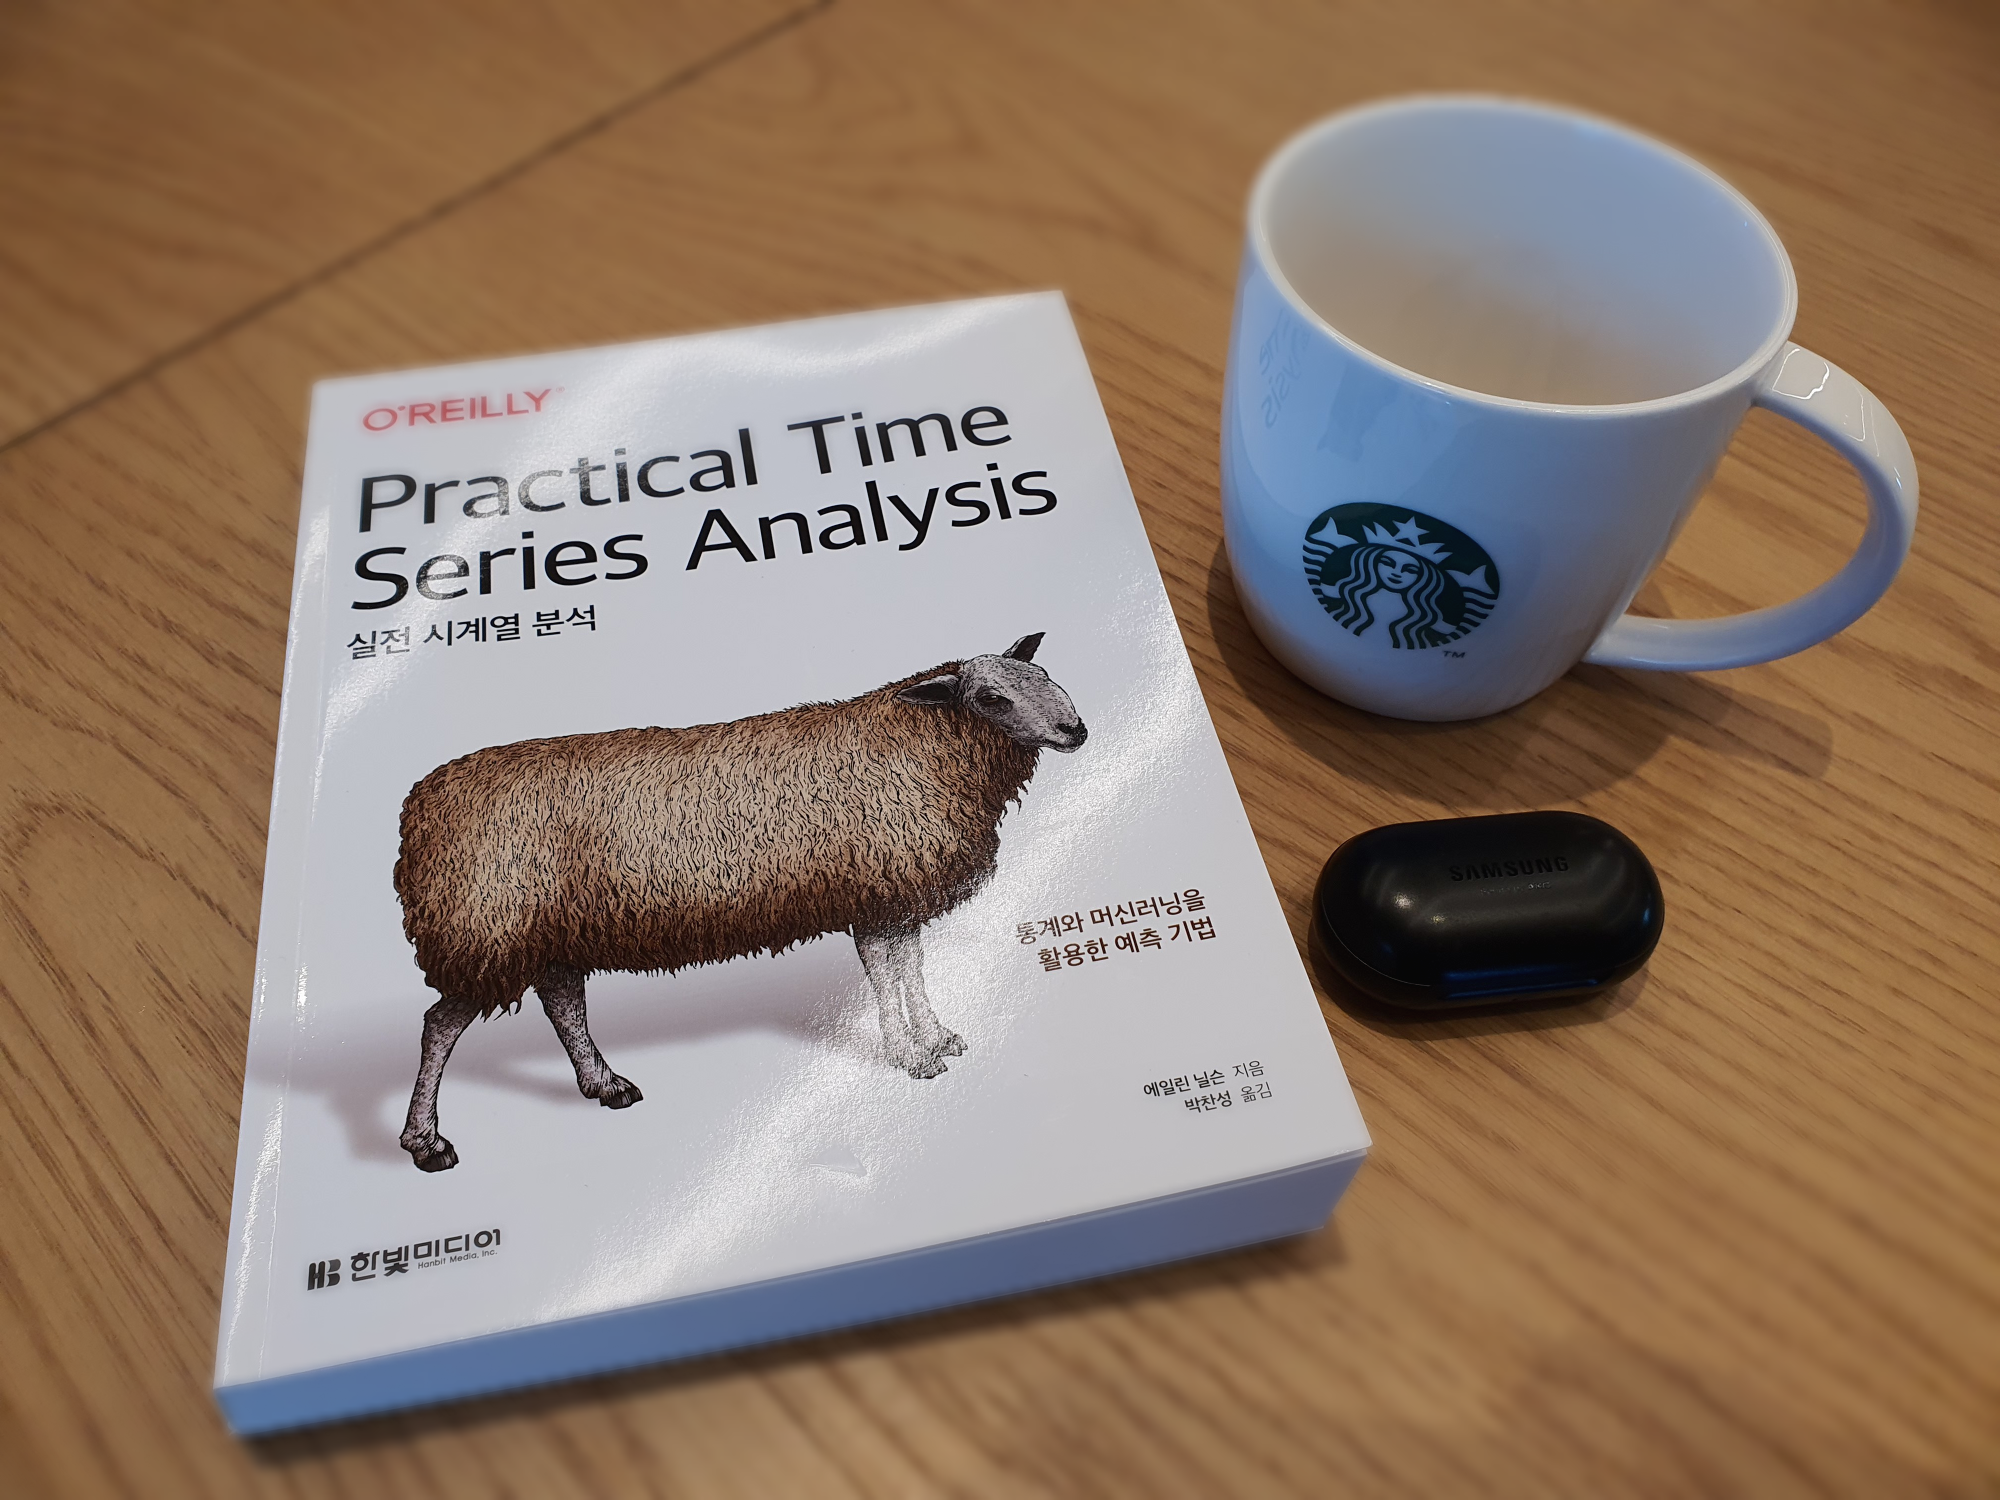
실전 시계열 분석
실제 환경에 특화된 시계열 데이터 분석 및 모범 사례를 다루는 실무 지침서다. ARIMA 및 베이즈 상태 공간 같은 표준적인 통계 모델과 계층형 모델을 폭넓게 다루고, 시계열 데이터 모델링의 현대적인 파이프라인 전체를 실용적인 관점에서 안내한다.
- 저자 : 에일린 닐슨
- 번역 : 박찬성
- 출간 : 2021-04-09
책의 제목 『Practical Time Series Analysis 실전 시계열 분석』 에서 알 수 있듯이 이 책은 실제 환경에서의 시계열 데이터 분석에 초점을 맞춤 실무 지침서이다. 즉, 입문서가 아니다. 저자는 대상 독자로 다음 두 분류를 이야기한다.
- 숙련된 산업 종사자나 주니어 분석가, 그러나 시계열 데이터는 다뤄보지 않은 데이터 과학자
- 대규모 데이터를 수집하는 기관에 소속된 관리자
같은 이유에서 책을 읽으려면 데이터 분석에서 많이 쓰이는 언어와 라이브러리(패키지) 등 일부 도구에 대해서는 익숙해야한다고 소개한다. R과 R의 data.table 같은 패키지 그리고 파이썬과 머신러닝에 많이 사용되는 Numpy, Pandas, scikit-learn 등이 대표적이다. 이와 함께 통계학과 머신러닝의 필수 개념인 아래 내용은 보완할 수 있는 다른 책들을 함께 보는 것이 좋다.
- 통계학: 분산, 상관관계, 확률분포 등
- 머신러닝: 군집화, 의사결정 트리 등
- 신경망 ...
정리하자면,
이 책은 500페이지가 넘는 분량으로 상당히 두껍고 입문자들을 배려하는 책은 아니다. 다만 앞서 말한 프로그래밍 도구들이나 패키지들에 익숙하다면 읽어 나가는데 큰 무리는 없다. 물론 실전에 적용하는 것은 다른 문제. 전통적인 기법으로 시계열 데이터를 분석하는 방법이나 도구에 대한 자료는 꽤 많이 있는데 머신러닝을 이용해 시계열 데이터를 처리하는 방법에 다룬 자료는 생각보다 많지 않다. 그만큼 이 책이 가치있다고도 볼 수 있고, 아직도 전통적인 기법들이 상당히 훌륭한 성능을 보인다고도 볼 수 있다. 맹목적으로 머신러닝을 믿을 순 없지만, 발전한지 아직 얼마 되지 않았으니 앞으로 더 기대할 수 있을 것이다. 그런 면에서 이 책은 기본을 미리 닦아두고 흥미를 유발하기에도 충분하다. 물론 실전적인 내용도 빠짐없이 풍부하게 포함되어 있어서 더욱 좋다.


