독자리뷰
만들면서 배우는 파이토치 딥러닝
rosas***
2021-09-22

만들면서 배우는 파이토치 딥러닝
입문서에서는 알기 어려웠던 전이학습과 파인튜닝을 활용한 화상 분류, 물체 감지, 시맨틱 분할, 자세 추정, GAN을 활용한 화상 생성 및 이상 탐지, 텍스트 데이터 감정 분석, 동영상 데이터 클래스 분류를 12가지 모델로 구현하며 배울 수 있다.
- 저자 : 오가와 유타로
- 번역 : 박광수(아크몬드)
- 출간 : 2021-08-05
딥러닝. 들어보기도 접하기도 참 쉬운 분야가 되었지만, 여전히 공부하기에는 어려운 분야입니다. 특히 영상 처리에 딥러닝을 적용하여 물체를 식별하는 과정은 실제로 어떻게 작동하는지 이해하기 쉽지 않습니다.
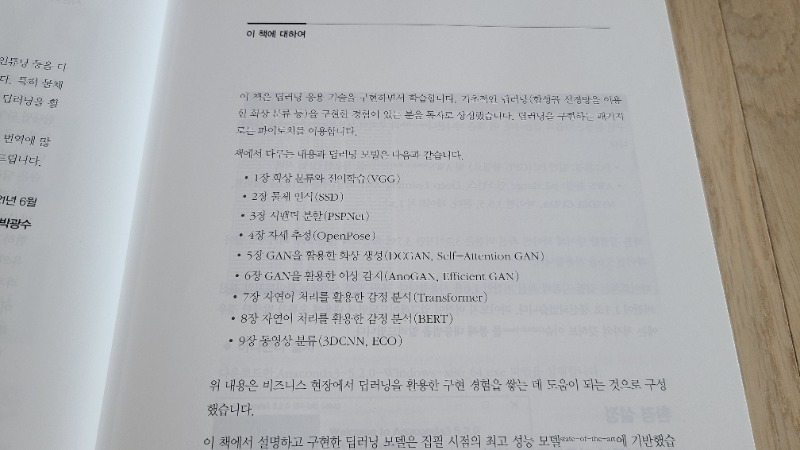
책 <만들면서 배우는 파이토치 딥러닝>에서는 텐서플로우에 대응되는 딥러닝 구현 라이브러리인 파이토치를 이용하여 딥러닝을 구현하는 방식을 예제를 바탕으로 다루고 있습니다. 각 장의 주제인 화상 분류와 전이학습, 물체 인식, 시맨틱 분할, 자세 추정, GAN을 이용한 화상 생성, GAN을 활용한 이상 감지, 자연어 처리를 활용한 감정 분석, 동영상 분류를 할 수 있는 모델을 구현하는 방법을 각각 코드를 한 줄 한 줄 뜯어보며 실제 코드를 활용해 구체적으로 설명하는 것이 특징입니다.
모든 모델들이 실제로 딥러닝이 활용되는 분야들을 잘 대표한다는 것과, 입문 단계에서 배우기 힘든 전이학습과 같은 기법을 다룬다는 점에서 이 책은 특별합니다. 전문성과 범용성을 두루 갖춘 책이라고 할 수 있을 것 같습니다.
각 챕터에서 다루는 모델들이 모두 중요하고 또 활용도도 높다고 생각되었지만, 영상 처리에 딥러팅을 활용하는 것에 대해 궁금해하실 분들이 많을 것 같아 관련 내용을 다루는 1장과 2장의 내용을 중심으로 다뤄보려 합니다.
전이학습이란 데이터가 부족한 분야에서 주로 사용하는 방법으로, 특정 환경에서 사용되기 위해 구현된 모델을 비슷하지만 다른 종류의 데이터 또는 환경에서 활용하는 것입니다. 이 책에서는 전이학습을 실제로 보여주기 위해 VGG-16 모델을 주어진 종류의 데이터인 벌과 개미의 사진을 분류하는 데 사용합니다. 이 모델은 이미지의 특징을 추출하고 크기를 축소하여 처리하기 쉬운 형태로 만들고, 최종적으로 이미지를 분류합니다. 이 책의 1장에서는 이 과정을 각 코드와 모델 자체에 대한 구체적인 설명을 곁들여가며 소개하고 있습니다.
이 책의 2장에서는 물체를 감지하는 방법, 즉 사진에 포함된 각 물체의 영역과 이름을 출력하는 모델을 구현하는 방법을 소개하고 있습니다. 이 모델은 먼저 사진을 정해진 크기로 변형하고 변형된 사진에서 여러 개의 구획을 뽑아낸 뒤, 각각의 구획 내의 각각의 물체가 존재할 확률을 계산하여 물체가 존재할 것이라고 믿어지는 신뢰도가 높은 경우의 구획을 추출하여 해당 구획과 구획 내에 존재할 것으로 예상되는 물체의 이름, 그리고 신뢰도를 최종적으로 보여줍니다. 1장에서 제시된 사진을 분류하는 모델보다는 많이 복잡하지만, 모델을 이해하는 데 필요한 이론과 수식, 그리고 모델의 구현 과정을 꼼꼼히 소개해주고 있기 때문에 내용을 이해하는 데에는 전혀 문제가 없습니다.
추상적인 것처럼 보여 쉽사리 손에 잡히지만 않을 것 같은 기술도 이 책, <만들면서 배우는 파이토치 딥러닝>을 통해서라면 구체적이고 쉽게 익힐 수 있습니다. 12가지의 서로 다른 모델들을 직접 구현해보며 딥러닝을 몸소 익힐 수 있는 이 책을 딥러닝에 대한 기초가 갖춰진 분들게 적극 추천하고 싶습니다.
"한빛미디어 <나는 리뷰어다> 활동을 위해서 책을 제공받아 작성된 서평입니다."


