독자리뷰
파이썬 라이브러리를 활용한 데이터 분석(2판)을 읽고
moo***
2021-09-17

파이썬 라이브러리를 활용한 데이터 분석(2판)
이 책은 NumPy, pandas, matplotlib, IPython, Jupyter 등 다양한 파이썬 라이브러리를 사용해서 효과적으로 데이터를 분석하는 방법을 알려준다. pandas의 새로운 기능뿐만 아니라 메모리 사용량을 줄이고 성능을 개선하는 고급 사용법까지 다룬다. 또한 모델링 도구인 statsmodels와 scikit-learn 라이브러리도 소개한다. 연대별 이름 통계 자료, 미 대선 데이터베이스 자료 등 실사례로 따라 하다 보면 어느덧 여러
- 저자 : 웨스 맥키니
- 번역 : 김영근
- 출간 : 2019-05-20
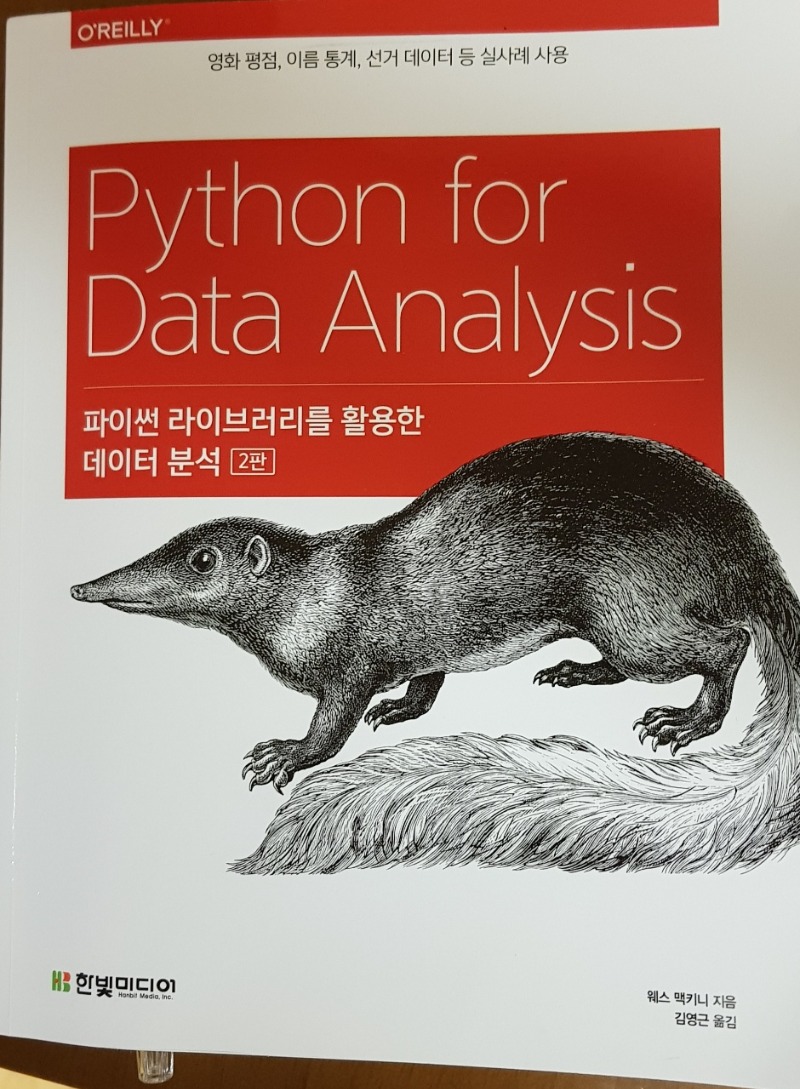
이 책을 본 순간 처음 드는 느낌, '와 두껍다'. 무려 700 페이지에 육박하는 도서였습니다. 책 두께가 두꺼운 만큼, 내용도 많다는 의미겠지요. 반면에 어려운 내용을 잘 풀어서 설명해서 처음 접근하는 사람이 그나마 덜 부담스럽게 느낄 수 있는 책이라고도 볼 수 있습니다. 이 책은 바로 그런 책이라는 생각이 듭니다.
책의 작가인 웨스 맥키니는 pandas 프로젝트를 시작한 사람입니다. 데이터 분석에 관한 책이면서, 파이썬 라이브러리를 활용하는 것이라고 제목에 나타나있지만, 실은 책의 대부분의 내용은 pandas 에 대한 내용으로, pandas 설명서라고 불러도 과언이 아닐 듯 합니다. 어느 책에서나 대체로 그러하듯이, 초반에는 예제를 사용하기 위한 환경과 기초 개념에 대한 설명이 있습니다. 4장에 이르러서 numpy에 대한 기본 내용을 다룹니다. 이후 5장부터 12장까지는 pandas 사용법에 대한 내용입니다. 데이터 분석에 pandas 라이브러리가 얼마나 큰 비중을 차지하고 있는지 알 수 있는 단적인 내용입니다. 하지만, 그 뒤에 13장에서는 Patsy, statsmodels, scikit-learn 과 같은 모델링 라이브러리를 사용하는 방법과 14장에서 데이터 분석도 다루고 있기 떼문에, 데이터 분석이라는 분야에서 필요한 부분을 폭넓게 다루고 있다고도 생각합니다. 또 appendix에서는 앞에서 기본만 다룬 numpy를 좀 더 심층있게 다루고 있고, IPython 사용법도 다루고 있기 때문에 데이터 분야의 개발을 담당하는 사람에게는 실용적인 책일 것입니다.
개인적으로는 파이썬을 접할 기회가 적어서, 다른 기술 문서의 코드를 보면서, 대략 이러하게 진행되는구나 정도만 파악했는데, 파이썬 기초를 다루고 있고, 개념을 간단 명료하게 잘 설명해줘서, 그 뒤에 이어지는 numpy나 pandas 사용 코드를 보는데도 상당히 도움이 되었습니다. 특히 슬라이싱과 값 분리하기 등과 같은 개념은 pandas의 기본 자료형인 Series와 DataFrame을 이용하는 코드에서는 필수적으로 이해해야 하는 내용인데, 미리 잘 파악하게 해둬서 도움이 많이 되었습니다.
pandas 는 알아갈수록 놀라운 라이브러리인 것 같습니다. 복잡한 데이터 형태를 많이 다뤄보지 않은 이유도 있겠지만, 테이블 형태의 데이터를 이렇게 다양한 방식으로 처리할 수 있는지, 또 이렇게 간단히 해낼 수 있는지 경이롭습니다. 데이터을 생성하고, 검색하고, 연산하고, 필터링하고, ... 그것도 좋은 성능으로 해내니, 인기가 많은 이유겠지요.
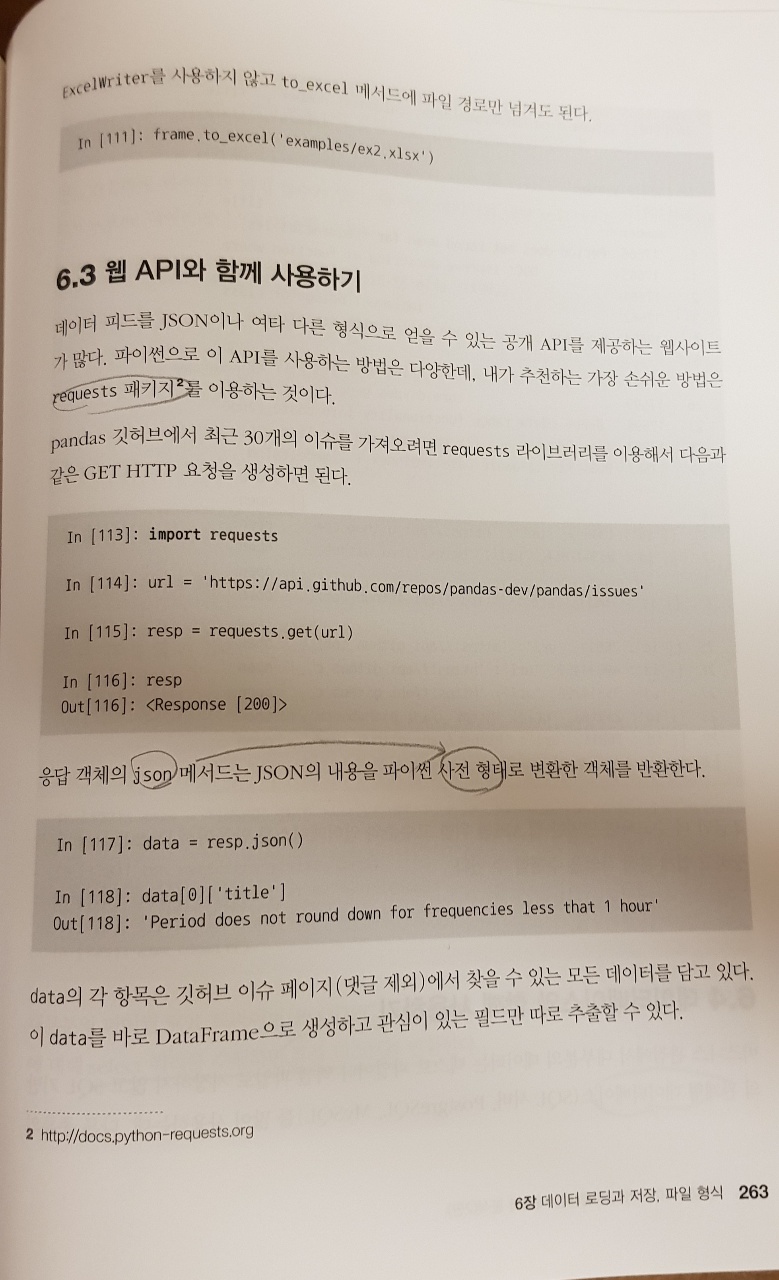
데이터를 다루는 외부 자료나 툴과의 연동도 간단하게 할 수 있는 것도 마음에 듭니다. csv이나 JSON 같은 형태는 많이 사용하고 있어서 기본일 수는 있겠지만, 엑셀이나 외부의 데이터베이스, 웹 API까지 연동이 된다니 지원하는 편의성이 감탄스럽습니다.
압도하는 책의 내용량으로 아직 완독을 하진 못했지만, 앞으로 이어질 흥미롭고 놀라울 내용이 기대가 됩니다. 진입 장벽을 느낄 수 있는 데이터 분석이라는 분야에 시발점으로 삼을 수 있는 좋은 책을 만난 것 같습니다. 그리고, 이제는 너무나 인기 분야가 되어 버린 AI 에서도 소양이 될 지식을 전달해 줄 수 있는 훌륭한 책입니다.
한빛미디어 <나는 리뷰어다> 활동을 위해서 책을 제공받아 작성된 서평입니다.


