독자리뷰
파이썬으로 웹 크롤러 만들기(2판) 리뷰
chlwnstj***
2021-08-23

파이썬으로 웹 크롤러 만들기(2판) : 초간단 나만의 웹 크롤러로 원하는 데이터를 가져오는 방법
웹에 존재한다면 그것이 어떤 형태이든 데이터로 추출할 수 있다. 필요한 무기는 이 책과 파이썬뿐. BeautifulSoup, 셀레니움, 테서랙트 등 강력한 파이썬 라이브러리 사용법과 함께 API, 인증, 이미지 및 텍스트 인식, 로그인 처리 등 웹 크롤링의 기초부터 고급 기법까지 종합적으로 다루는 유일한 책. 실제 업무와 생활에 적용할 수 있는 예제가 가득하다. 2판은 예제를 추가 및 업데이트했고 모던 웹에서 거의 모든 종류의 데이터를 가져오는 방법을
- 저자 : 라이언 미첼
- 번역 : 한선용
- 출간 : 2019-03-29
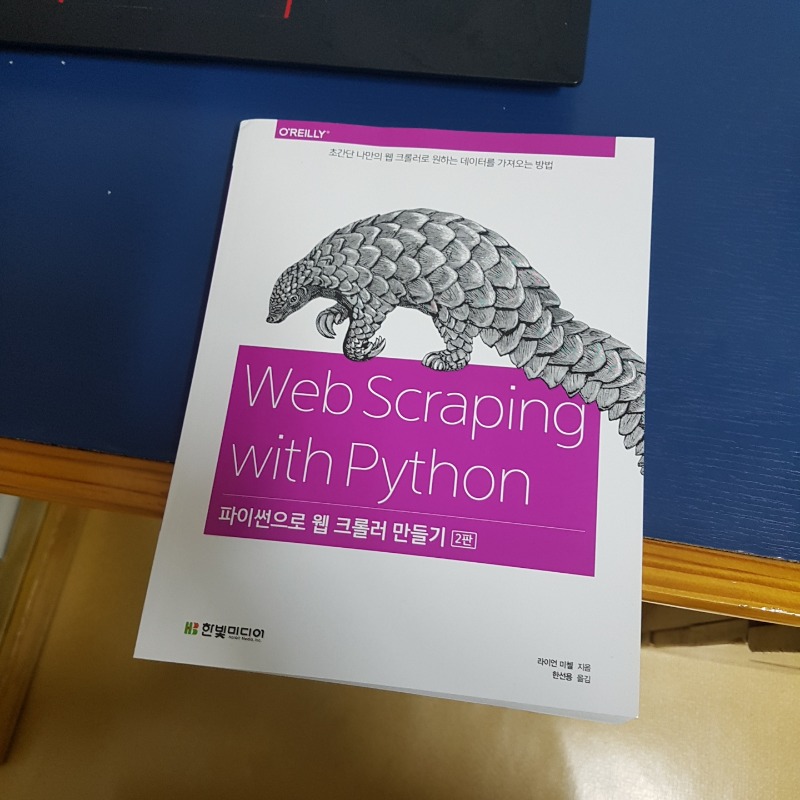
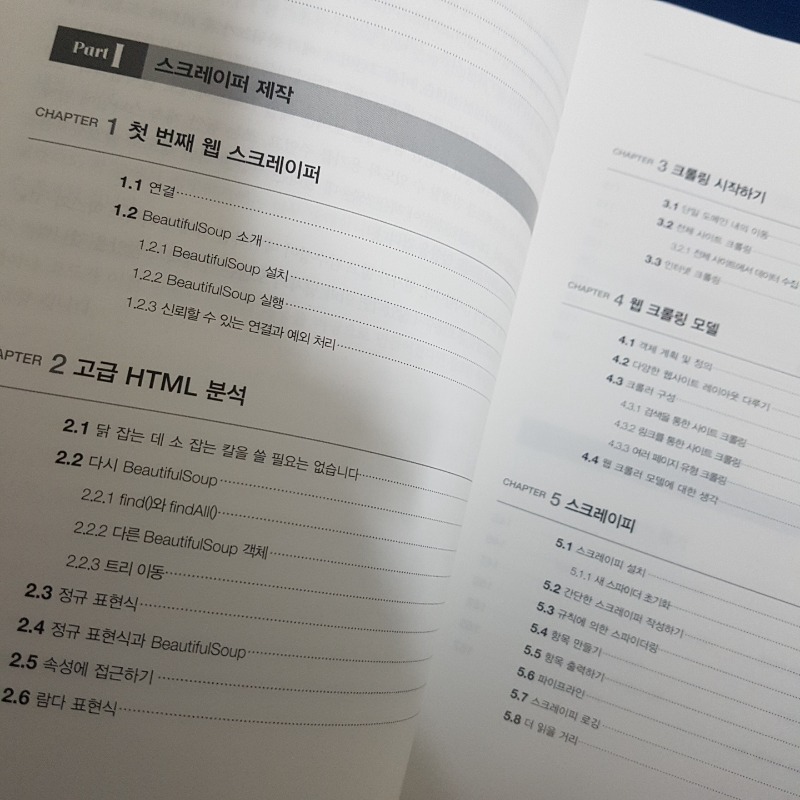
파이썬으로 웹 크롤러 만들기 2판이 나왔습니다.
웹에는 많은 정보들이 떠돌아 다니고 있습니다. 그러한 정보들을 몰아서 가공하는 능력을 가진다는 것은 앞으로 다가올 혹은 이미 닥쳐온 시대에 꼭 필요한 것일겁니다. 그러한 이유로 다루기 쉬운(?) 파이썬으로 웹 크롤링을 배우는 것은 어쩌면 필요한 능력을 얻는데 가장 쉬운 길일 수도 있습니다. 초판이 나온지 5년이 지난 후 2판이 나온 것은 그러한 필요에 의해 아직도 중요하다 생각하는 기술이라 그럴 것입니다.
또한 웹에서 정보를 모으는 기술은 머신러닝과도 깊은 관련을 가집니다. 자연어 처리가 그것입니다.
이 한권으로 웹 크롤링과 그것으로 모은 정보를 처리하는 모든 것을 배울 수는 없지만 그 문을 여는 것은 가능합니다.
책에 있는 코드를 따라 쳐보며 웹 크롤링을 배워보시길 바랍니다.
한빛미디어 <나는 리뷰어다> 활동을 위해서 책을 제공받아 작성된 서평입니다.


