독자리뷰
데이터 과학을 위한 최고의 참고서!!
qor***
2021-05-23

데이터 과학을 위한 통계(2판)
데이터 과학의 관점에서 통계 핵심 개념과 기법을 필요한 것만 골라 소개하는 책. EDA, 표본분포, 유의성 검정, 회귀분석, 분류, 통계적 머신러닝, 비지도 학습 등 오늘날 데이터 분석과 머신러닝 분야에서 널리 사용하는 주제로 구성됐다.
- 저자 : 피터 브루스 , 앤드루 브루스 , 피터 게데크
- 번역 : 이준용
- 출간 : 2021-05-07
통계학과 데이터 과학의 만남: 데이터 과학을 위한 통계, 2판
‘데이터’의 중요성이 날로강조되는 요즘이다. 최근 화두인 4차 산업 혁명의 핵심 기술은관점에 따라 여러가지로 나눌 수 있지만, 인공지능과 데이터 활용 기술은 핵심 중의 핵심이라는 데 이견이별로 없을 것이다. 인공지능이 21세기에 들어 각광받게 된데에는 컴퓨팅 파워의 급격한 발전, 인터넷 등 초고속 네트워크를 기반으로 하는 통신 기술과 함께 스마트폰 등 다양한 장치로부터 생산되는 대용량의 데이터가 큰 역할을 했다. 머신 러닝으로 대표되는 최근의인공지능 기술은 학습을 위한 대용량의 데이터가 필수적이다. 이렇게만 보면 4차 산업 혁명의 핵심이 데이터라고 해도 과언이 아닐 것이다.
이렇게 데이터, 특히 과거에는 생각할 수도 없을 만큼 대량의 데이터를처리하는 방법은 데이터 과학이라는 분야를 더욱 활발히 발전시키고 있다. 전통적으로 대량의 데이터를 다루는학문은 통계학이었다. 통계학은 현재의 데이터 과학에서도 여전히 유효하며, 데이터 과학을 발전시키는 큰 축을 이루고 있다. 실제로 데이터 과학은통계학, 컴퓨터 과학, 정보 기술, 도메인 특화 영역 등 여러 분야의 융합 학문이라고 할 수 있다.
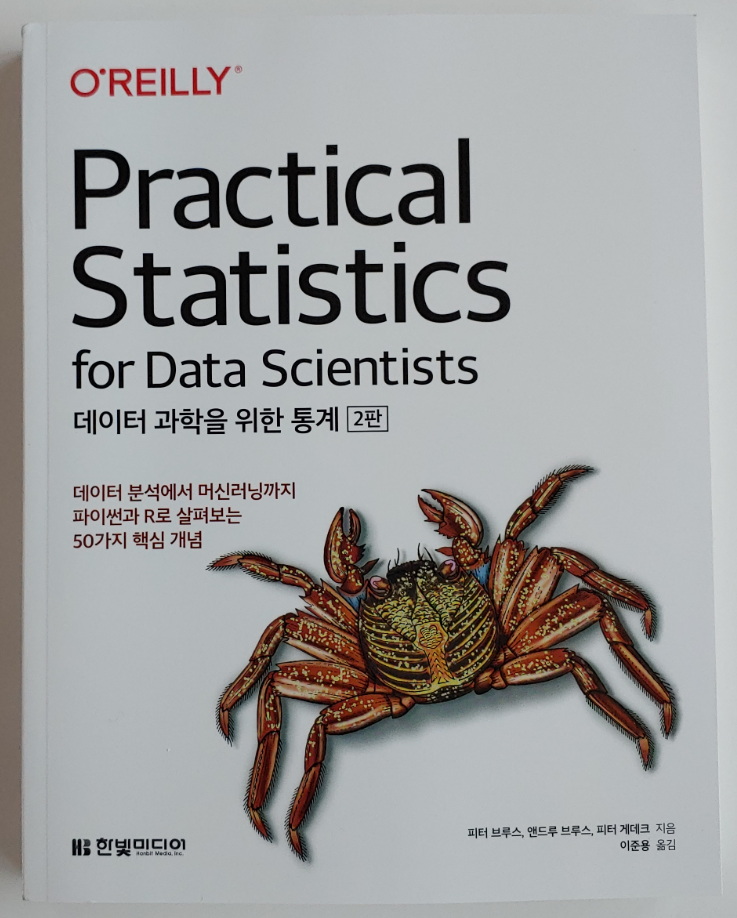
‘데이터 과학을 위한 통계(2판)’은 데이터 과학과 관련된 통계의 핵심 개념들을 알기 쉽게 소개하며, 데이터과학의 관점에서 통계학의 많은 개념 중, 어떤 내용이 중요하고, 유용한지과학적인 이유를 들며 설명하고 있다.
이 책은 7개의 챕터(장)로 구성되어 있다. 1장, ‘탐색적데이터 분석’에서는 테이블 데이터, 위치 및 변이 추정, 데이터 분포 탐색에 대해 다룬다. 2장, ‘데이터와 표본 분포’는 임의표본추출과 표본편향, 선택편향과 함께 정규 분포, 긴 꼬리 분포, 이항분포, 푸아송 분포 등 다양한 분포에 대해 소개한다. ‘통계적 실험과 유의성검정’이라는 주제의 3장은 A/B검정, 가설검정, 재표본추출, 다중검정, 자유도및 검정력과 표본 크기 등을 이야기하고 있다. 4장의 ‘회귀와예측’에서는 단순 선형 회귀, 다중 선형 회귀, 회귀를 이용한 예측 및 회귀방정식 해석, 회귀진단, 다항회귀와 스플라인 회귀에 대해 다룬다. 5장 ‘분류’는 나이브 베이즈, 판별분석, 로지스틱 회귀, 분류 모델 평가 방법과 함께 불균형 데이터를 어떻게다루어야 하는지 소개한다. ‘통계적 머신러닝’의 6장은 k-최근접 이웃, 트리모델, 배깅과 랜덤 포레스트, 부스팅의 소주제를 이용하여 데이터에 따라유연하게 지역적으로 학습하는 분류와 예측방법을 다룬다. 비지도학습은 레이블이 달린 데이터를 이용해 모델을학습하는 과정없이 데이터로부터 의미를 이끌어 내는 통계적 기법을 의미하는데, 7장은 이를 다루고 있다. 7장에서는 수치형 데이터의 차원을 축소하기 위해 주로 사용하는 방법인 주성분분석과 k-평균 클러스터링을 소개하고, 수치형과 범주형이 혼합된 데이터 유형에적용할 수 있는 계층적 클러스터링, 통계 이론에 기초를 두고 더 엄밀한 접근 방식을 제시하는 모델 기반클러스터링의 내용도 포함한다.
이책은 R이나 파이썬 프로그래밍에 익숙하고, 이전에 통계학을잠깐이라도 접해본 경험이 있는 데이터 과학자를 대상으로 하고 있다. 2판으로 개정되면서 파이썬 코드가추가되어, R 뿐만 아니라 파이썬을 이용하여 실습을 진행할 수 있다.책의 중간 중간 ‘주요 개념’을 정리해주어 독자로하여금 어디에 초점을 두고 책을 읽어야 하는지, 그리고 핵심 내용을 잘 이해하고 있는 지 살펴볼 수있도록 하고 있다. 더불어 ‘더 읽을 거리’를 통해 책에서 다루고 있지 못한 내용이나 관련 자료를 찾아볼 수 있도록 안내하고 있다. ‘데이터 분석에서 머신 러닝까지, 파이썬과 R로 살펴보는 50가지 핵심 개념’이라는부제처럼 이 책은 머신러닝을 포함한 데이터 과학 전반을 통계적 관점에서 깊이 있게 다루고 있어 데이터 과학을 배우고자 하는 독자들에게 좋은 참고서가될 것이다.
** 한빛미디어 <나는 리뷰어다> 활동을 위해서 책을 제공받아 작성된 서평입니다.


