독자리뷰
실전 시계열 분석
one2***
2021-05-18

실전 시계열 분석
실제 환경에 특화된 시계열 데이터 분석 및 모범 사례를 다루는 실무 지침서다. ARIMA 및 베이즈 상태 공간 같은 표준적인 통계 모델과 계층형 모델을 폭넓게 다루고, 시계열 데이터 모델링의 현대적인 파이프라인 전체를 실용적인 관점에서 안내한다.
- 저자 : 에일린 닐슨
- 번역 : 박찬성
- 출간 : 2021-04-09
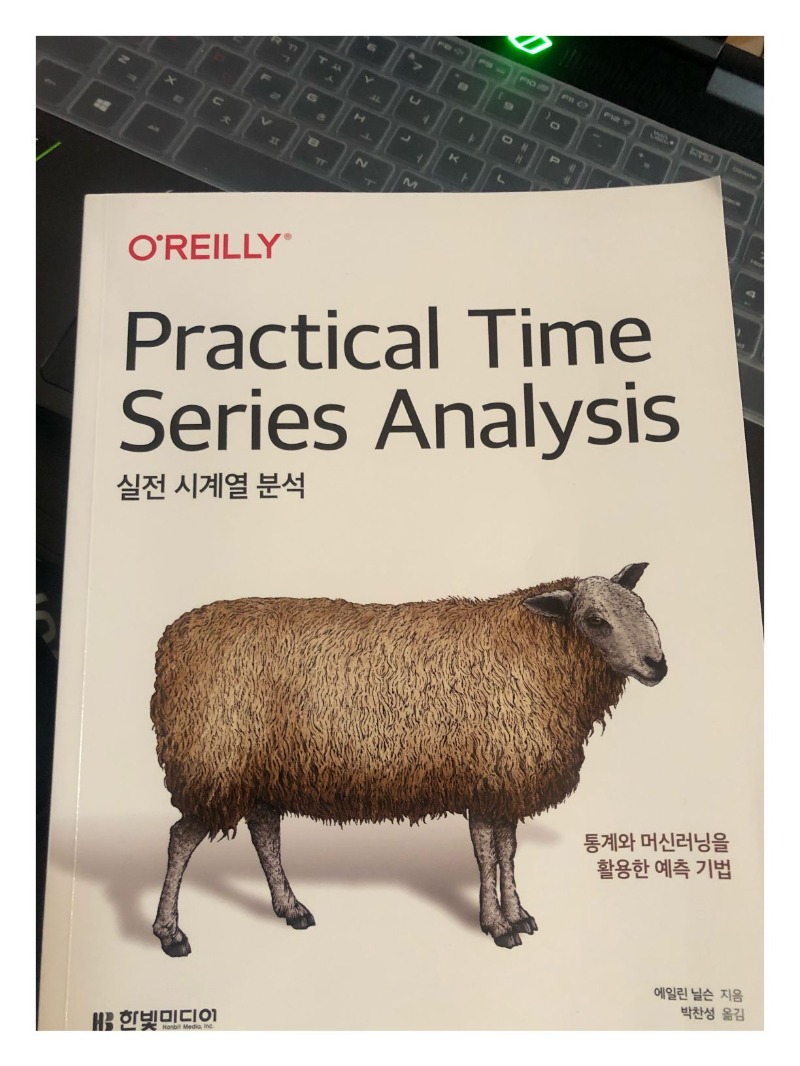
이 책은 '시계열'이라는 분야를 과거 전통적으로 사용되어온 통계적인 방법부터 최긍 딥러닝 방법까지 다루고 있습니다.
실제로 사용되는 사례 뿐만 아니라 이론적인 면까지 꼼꼼히 다루고 있습니다.
이 책을 선택한 이유는 우리 주변에서 볼 수 있는 대부분의 데이터는 시계열 데이터이기 때문에 반드시 공부해야할
분야라 생각했기 때문입니다.
금융데이터, 고객의 구매 이력 및 의료 데이터 등 뿐만 아니라 동영상 데이터, 음성데이터 그리고 ECG나 심장 박동, 호흡 소리 등
우리 주변에서는 시간의 흐름 혹은 다른 기준이 되는 척도에 따라 인과 관계가 있는 데이터로 가득합니다.
이 책은 시계열의 개요와 역사에 대해서 설명하면서 시작을 합니다. 통계적 분석의 기원, 머신러닝 시계열 분석의 기원등을 설명하면서
우리가 왜 시계열 데이터 분석을 공부 해야하는지 이유를 설명하고 있습니다.
그리고 시계열 데이터가 어떤 것인지, 그리고 어떻게 구해야하는지 어떤 특징이 있는지 설명을 하고 있습니다.
시계열 데이터 중에 중간에 누락된 데이터를 처리하는 방법과 각 특징에 따른 시계열 데이터의 처리 방법에 대해 설명을 하고 있습니다.
그리고 나서 시계열 데이터의 통계적 모델을 설명하고 있으며, 머신러닝과 딥러닝에서의 시계열 데이터 분석 방법을 설명합니다.
시계열 데이터를 학습 데이터, 검증데이터 및 시험데이터로 나눌때 주의해야할 점, 그리고 검증을 할때 주의해야할 점은
앞으로 데이터를 다룰 때 많은 도움이 될 것 같습니다.
이 책의 모든 내용을 한번에 이해하기는 어렵습니다. 옆에 두고 계속 참고하면서 몇번이고 다시 읽으면서 공부할 수 있는
책입니다. 시계열에 관련된 책을 한권 본다면 이 책이 적절한 것 같습니다.
"한빛미디어 <나는 리뷰어다> 활동을 위해서 책을 제공받아 작성된 서평입니다."


