독자리뷰
개인정보를 보호하며, 학습데이터셋을 구축하자!!!
pjh***
2021-02-21

머신러닝을 위한 실전 데이터셋
이 책은 실제 데이터로 합성 데이터를 만들어 머신러닝을 비롯한 다양한 산업에 사용하는 방법을 제공합니다. 실제 데이터에서 발생하는 개인 정보 문제를 해결하는 방법과 합성 데이터를 생성하는 원칙과 단계를 배우며, 합성 데이터가 제품이나 솔루션 개발에 어떤 이점이 있는지를 학습합니다
- 저자 : 칼리드 엘 에맘 , 루시 모스케라 , 리처드 홉트로프
- 번역 : 심상진
- 출간 : 2021-01-04
이 책은 머신러닝을 위한 실전 데이터셋을 제작할 수 있도록 도와준다.
인공지능 모델을 개발하기 위해서는 첫째로 학숩용 데이터셋을 구축해야 한다.
최근에 GDPR, HIPAA와 같은 개인정보 보호 규정으로 인해 개인 데이터를 2차 목적으로 사용할 때 법적 근거를 요구한다.
이런 이유로 기존 데이터셋에서 합성데이터셋이 구축되어야 한다.
제조와 유통 , 헬스케어, 디지털 의료기술 ,금융서비스, 교통 산업 분야에서 다양하게 합성데이터셋의 활용이 기대된다.
저자는 합성데이터셋의 적합성과 효용성의 기준을 제시하며, 통계적 분포에 따른 합성 방법론을 제안한다.
인공지능 모델링의 성공은 양질의 데이터셋의 구축여부에 따라 성패가 달려있다.
앞으로도 개인정보는 보호되어야 하며, 효과적인 인공지능 모델링을 위해서는 효용성있는 합성 데이터셋의 구축 기술이 요구된다.
1독을 권한다.
목차는 다음과 같다.
목차
CHAPTER 1 합성 데이터 생성 소개
1.1 합성 데이터 정의
1.2 합성 데이터의 이점
1.3 합성 데이터의 활용 사례
1.4 요약
CHAPTER 2 데이터 합성
2.1 합성 시기
2.2 식별화 가능성 스펙트럼
2.3 데이터 접근 활성화를 위한 PET 선택의 절충
2.4 데이터 합성 프로젝트
2.5 데이터 합성 파이프라인
2.6 합성 프로그램 관리
2.7 요약
CHAPTER 3 시작: 분포 적합
3.1 데이터 프레임
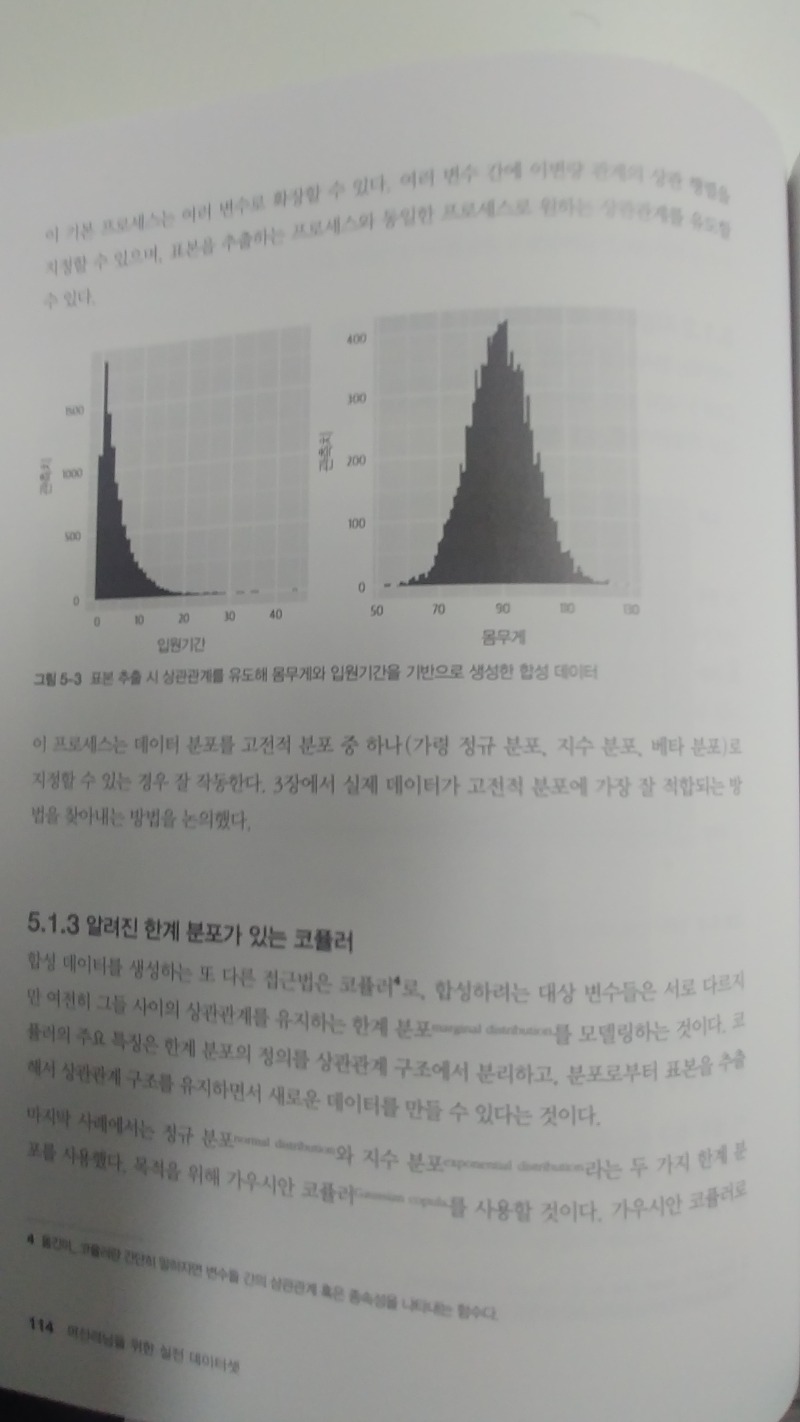
3.2 데이터 분포 유형
3.3 실제 데이터에 분포 적합시키기
3.4 분포로부터 합성 데이터 생성
3.5 요약
CHAPTER 4 합성 데이터의 효용성 평가
4.1 합성 데이터 효용성 프레임워크: 분석 복제
4.2 합성 데이터의 효용성 프레임워크: 효용성 메트릭
4.3 요약
CHAPTER 5 데이터 합성 방법
5.1 합성 데이터 생성 이론
5.2 실제 합성 데이터 생성
5.3 하이브리드 합성 데이터
5.4 머신러닝 방법
5.5 딥러닝 방법
5.6 시퀀스 합성
5.7 요약
CHAPTER 6 합성 데이터의 신원 식별
6.1 노출 유형
6.2 개인 정보 보호법이 합성 데이터의 생성과 사용에 미치는 영향
6.3 요약
CHAPTER 7 실제 데이터 합성
7.1 데이터 복잡성 관리
7.2 데이터 합성 구성
7.3 결론


