독자리뷰
[리뷰] 안전한 인공지능 시스템을 위한 심층 신경망 강화 (적대적 공격에 속지 않는 심층 신경망 만들기)
j767a***
2020-12-24

안전한 인공지능 시스템을 위한 심층 신경망 강화
이 책은 인공지능 시스템을 속이는 적대적 공격을 소개합니다. 적대적 공격이 이미지, 오디오, 비디오 데이터를 활용해 인공지능을 속이는 실제 사례를 살펴봅니다. 신경망을 공격하거나 방어하는 방법을 깊이 있게 학습하고 예제 코드로 직접 실행해볼 수 있도록 구성하였습니다
- 저자 : 케이티 워
- 번역 : 김영하
- 출간 : 2020-12-01
본 책은 인공지능을 속이는 기술을 시작으로 책을 소개하고 있습니다. 보통 적대적 입력이라고 하면 GAN 적대적 신경망, Generative Adversarial Network에 관한 내용으로 잘 알려있습니다. 본 책은 심층 신경망 Deep Neural Network에 대하여 자세하게 다루어지고 있습니다. 즉 여러가지 도메인 이미지, 오디오, 자연어처리등에서 쓰이는 심층 신경망에 대하여 자세하게 다루고 있습니다.
본 책에서 머신러닝 모델을 훈련시키는 방법은 4가지로 나누어지고 있습니다.
머신러닝 모델 훈련에서 다양한 방법들이 있습니다.
1) 지도학습
머신러닝 모델은 라벨이 지정된 데이터셋을 사용하여 훈련을 합니다. 입력된 데이터를 기반으로 예상답변을 만들어냅니다.
2) 비지도 학습
라벨이 없는 데이터셋에서 패턴을 발견하고 머신러닝 모델을 훈련시킵니다. 이 알고리즘은 훈련 중에 '답변'을 표시하지 않고 데이터에 패턴을 설정합니다.
3) 반지도 학습
라벨이 부분적으로 지정된 훈련 데이터를 이용하는 학습 방법입니다.
4) 강화학습
모델 스스로 더 높은 점수를 얻기 위해 시스템을 지속적으로 테스트하며 새로운 모델을 만듭니다. 강화학습은 훈련 데이터 셋을 사용하지는 않지만 주어진 '환경'과의 상호작용을 통해 학습합니다.
책에서 언급하는 적대적 입력은 다소 저에게 신선하게 다가왔습니다.
'적대적 사례'라는 용어는 신경망을 '성공적으로' 속여서 인간이 부정확하다고 생각하는 예측을 생성하는 입력을 의미하게 됩니다.
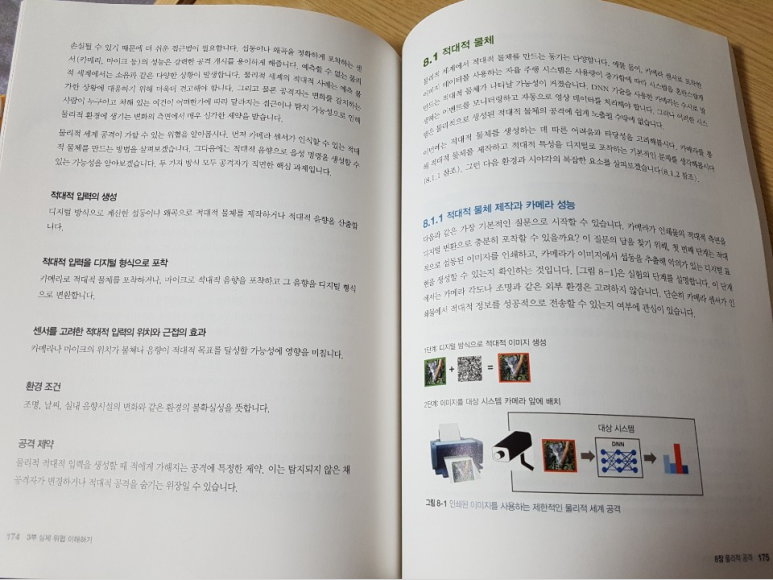
본 책에서는 소프트웨어 고유의 복잡성과 끊임없이 진화하는 멀웨어 특성으로 인해 위협을 나타낼 수 있는 소프트웨어의 특징을 명확하게 표현할 수 없으므로 멀웨어 검출에 신경망을 적용하는 일에 관심이 커지고 있습니다. 적대적 입력이라는 용어는 멀웨어 방지 소프트웨어가 머신러닝으로 구현할 때 멀웨어를 정의하는데 사용하기도 합니다. 즉 머신러닝 모델이 잘못된 '양성' 결과를 반환하도록 멀웨어가 입력되기 때문에 이는 논리적 정의이기도 합니다.
마지막으로 좋은 책 제공과 기회를 주신 한빛미디어 담당자 분들께 감사 드립니다. 1월에도 내용이 탄탄한 도서를 읽고 빨리 리뷰를 남기고 싶습니다.


