독자리뷰
안전한 신경망 강화와 적대적 공격의 방어를 위한 안내서
spaci***
2020-12-22

안전한 인공지능 시스템을 위한 심층 신경망 강화
이 책은 인공지능 시스템을 속이는 적대적 공격을 소개합니다. 적대적 공격이 이미지, 오디오, 비디오 데이터를 활용해 인공지능을 속이는 실제 사례를 살펴봅니다. 신경망을 공격하거나 방어하는 방법을 깊이 있게 학습하고 예제 코드로 직접 실행해볼 수 있도록 구성하였습니다
- 저자 : 케이티 워
- 번역 : 김영하
- 출간 : 2020-12-01
책 겉표지에도 나와 있듯이 적대적 공격에 속지 않는 심층 신경망 만들기를 주제로 내용을 싣고 있다.
내가 이해한 바로는 컴퓨터에도 악성코드를 넣을 수 있듯이 그럴싸한 입력 값을 주었을 때 인공지능이 공격자가 원하는 출력을 낼 수 있음과 그런 행위를 방어하는 방법을 다루었다. 개요는 아래와 같다.
1부 인공지능을 속이는 기술: 적대적 입력과 공격 동기를 소개하고 이미지와 오디오 데어터 처리를 위한 딥러닝의 기본 개념을 설명한다.
2부 적대적 입력 생성하기: 적대적 입력과 적대적 입력을 생성하는 방법을 구체적으로 설명한다.
3부 실제 위협하기: 2부에서 설명한 방법을 기반으로 공격자가 실제 세계에서 사용하는 공격 방법과 이떄 마주하는 어려움을 알아봅니다.
4부 방버: 3부의 내용을 기반으로 적대적 입력을 방어하는 방법을 알아봅니다.
23p에서 적대적 입력이란 무엇인가에 대해 명확하고 간략한 예시가 씌여있다.
이미지 처리 분야에서 말하는 '적대적 입력'의 개념은 인공지능에서 발생하는 착시 현상을 말합니다. 고양이 사진에 있는 픽셀을 일부 변형하면 인공지능은 '고양이 사진'을 '개'로 분류합니다. '개'라고 인식할 수 있는 변화를 넣어줌으로써 적대적 이미지를 생성하는 것입니다. 도로 표지판을 예로 들면 적대적 입력은 낙서로 보일 수도 있지만 자율 주행차가 표지판을 잘못 해석하도록 하는 표시가 될 수도 있습니다. 더 나아가 오디오로 확장해보면 음식 인식 시스템이 잘못 해석하도록 음성 내에 사람에게는 들리지 않는 적대적 명령을 포함할 수도 있습니다.
25p에서 적대적 섭동이란 무엇인가에 대해 씌여있다. 원본 이미지를 정교하게 계산한 후 각 픽셀을 조금씩 변경해 생성한 적대적 이미지입니다. 이것을 '섭동 공격'이라고 부릅니다. 전반적인 효과는 인간의 눈에 띄지 않거나 눈감아줄 정도로 매우 작습니다. 섭동은 무작위로 나타날 수 있지만 실상은 결코 그렇지 않습니다. 즉 각 픽셀은 필요한 결과를 얻기 위해 정교하게 조작된 것입니다.
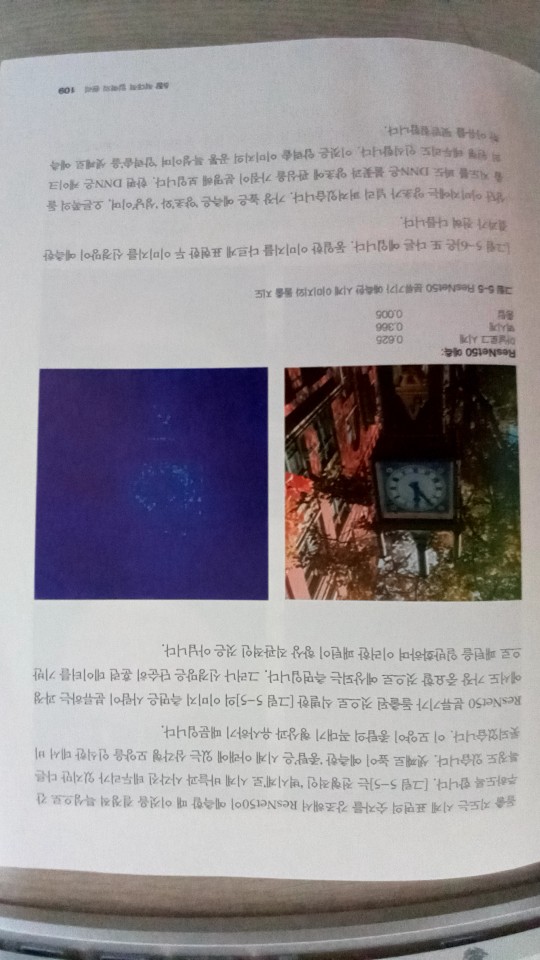
적대적 입력의 원리에서는 돌출 수학(Saliency Mathematics)라고 부르는 입력에 대한 출력의 편미분을 고려해 추정한 값을 사용합니다. 개념적으로 이것은 이미지가 j의 예측 지도에 있는 지점에서 픽셀 i에 해당하는 차수의 그레이디언트입니다.
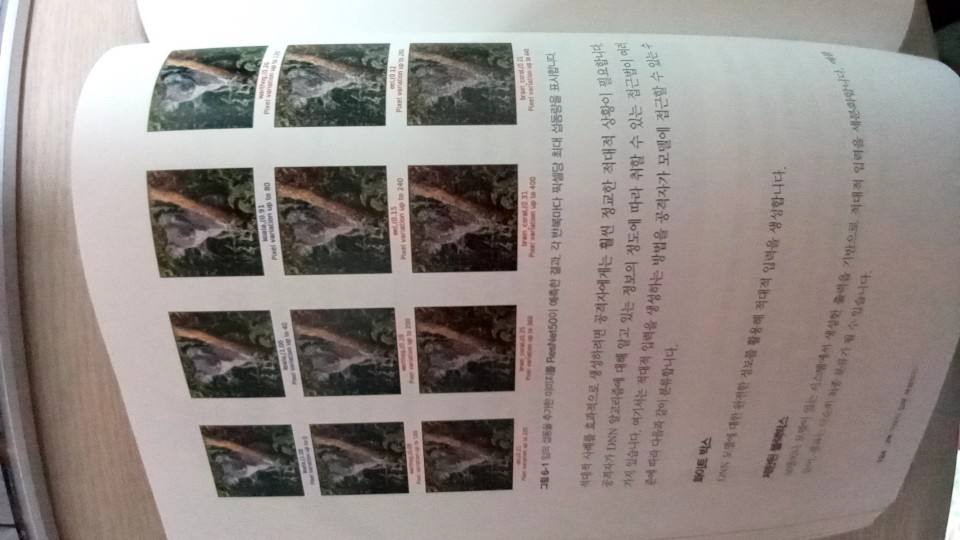
적대적 섭동을 생성하는 방법을 설명하는 내용이 핵심이라 볼 수 있는데 FGSM, JSMA, C&W의 수식과 제한된 블랙박스 방법, 점수 기반 블랙박스의 방법을 소개하고 있다.
적대적 공격과 심층 신경망에 대해 관심있는 독자분께 이 책을 추천드린다.


